DarkYellowCat's Blog

分享技术与思考

前言

解释和个人阅读感受

本书《深入理解 AI Agent:设计原理与工程实践》为李博杰所著并开源,地址为:https://github.com/bojieli/ai-agent-book, 截止 2026-09-07 已有 79 位贡献者, star 45k 。

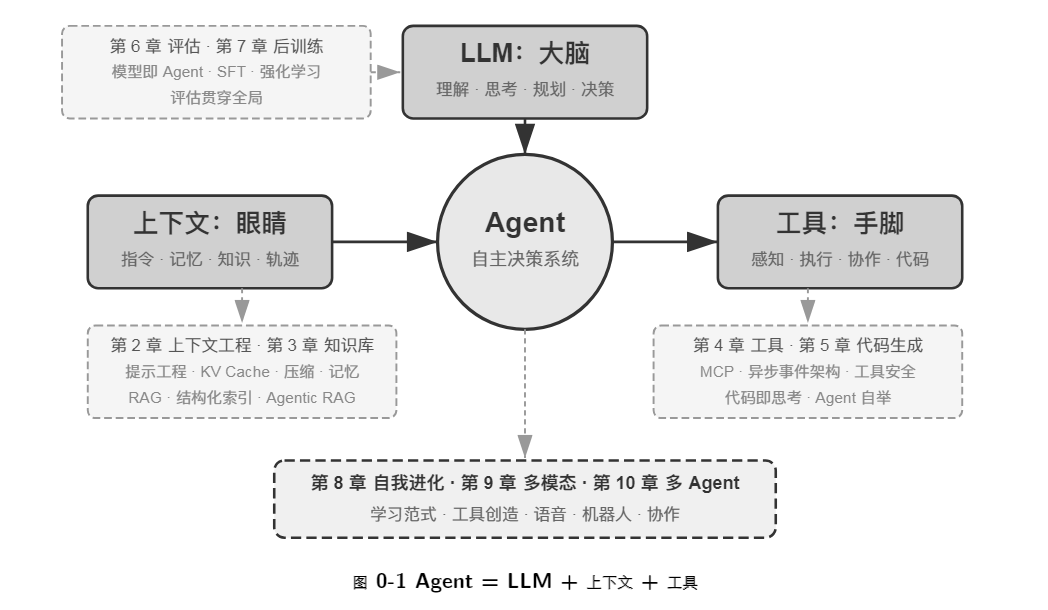
本书的核心观点是:Agent = LLM + 上下文 + 工具。作者开源了图书,并配套了 109 个实验,具体实验这里不做解释,需要的朋友可以在前面的链接自行查看并下载。
alt text

我是一位大三的计科学生,主要的方向是 Java web ,但结合我平时的所见所闻,我认为开发岗位与 Agent 的结合是势不可挡的,这也是我慕名学习本书的主要原因之一。

我在阅读时主要看重开发人员应该怎么去认识和使用Agent,实验部分我只会看得出的结论,没有实机测试。因此,这篇笔记可能更适合有同样情况的网友。如果您更希望深入理解其中的原理,我更推荐阅读原书。

而我阅读下来的体验是:虽然我之前没有系统了解 LLM 或 Agent 的原理,但这不影响我的阅读体验,我依然能从零开始理解各家 Agent 的设计结构和思路,并尝试怎么更好使用大模型来进行开发。作者的行文也平实易懂,我推荐大家有时间的话都可以阅读原著。

另外难得的一点是,他是少数成体系且时间上接近当前的书籍,不会出现书中的结论已经过时或被证伪的情况。我第一次在一本书中看到 GPT-5.6 的身影。

要求的前置知识-书中要求

必需:阅读全书的基础

Python 编程:书中几乎所有实验都基于 Python。你需要熟悉 Python 的基本语法、常用的数据结构、包管 理(pip)等基本概念。不要求精通,但应能读懂和修改中等复杂度的 Python 代码。

LLM 的基本使用经验:你应该用过 ChatGPT、Claude 或类似的产品,理解“提示词(Prompt)→ 模型回 复”的基本交互模式。

一款 AI 辅助编程工具:强烈建议安装并熟悉至少一款 AI 辅助编程工具,如 Claude Code、Codex、Cursor、 TRAE 等。一方面,这些工具能显著提高书中实验的开发效率,因为实验涉及大量代码编写和调试。另一方 面,这些编程工具本身就是成熟的 Coding Agent,你在使用它们的过程中会直观地体验到 ReAct 循环、工 具调用、上下文管理等书中反复讨论的核心机制。这种第一手体验对理解 Agent 的设计原则极有价值。

软件工程常识:熟悉命令行操作、Git 版本控制、JSON 数据格式、REST API 等基本概念。这些是运行实 验和理解 Agent 工具调用机制的基础。

推荐:提升特定章节的阅读体验

机器学习基础(第八章):了解训练与推理、损失函数、梯度下降、过拟合等基本概念,有助于理解模型后训 练。

基础数学(第 2-3、8 章):对线性代数有直观的理解(比如知道向量可以表示方向和大小、矩阵可以做批量运 算)有助于理解嵌入和注意力机制;基本的概率统计知识有助于理解评估指标和强化学习中的期望奖励。书 中的数学不涉及复杂的推导,侧重直观解释。

Web 开发基础(第 6 章):了解 HTTP、WebSocket、前后端分离架构等概念,有助于理解事件驱动的异步 Agent 架构和语音 Agent 的实时通信实验。

对 Transformer 架构的基本了解(第 2、8 章):Transformer 是当前几乎所有大语言模型的底层架构。对于 希望系统地补充大模型基础知识的读者,推荐阅读《图解大模型》(图灵出版)。该书以直观的图解方式讲解 了 Transformer 架构、预训练与微调等核心概念,与本书的 Agent 工程视角形成良好的互补。

第一章总观

从多个真实 Agent 产品出发,建立对 Agent 的直观理解。深入解析 Agent 的核心公式:从实现层的 LLM + 上下文 + 工具,到直觉层的大脑 + 眼睛 + 手脚,再到学术层的策略(Policy)、观察空间(Observation Space)与动作空间(Action Space)。同时通过实验剖析 ReAct 循环的运作机制,也就是“思考 → 行动 → 观察”的迭代过程,并区分任务内的上下文适应、跨任务的外部产物(artifact)更新和 训练周期中的参数更新。最后讨论从工作流到自主 Agent 的编排设计模式,为后续章节建立统一的概念框架。

对总观点的解释

Agent = LLM + 上下文 + 工具

  • LLM 是 Agent 的大脑:它不只是一组模型参数,而是 Agent 的整个决策内核——理解意图、思考规划、做出 判断。就像人类大脑不只是神经元的集合,还包括通过经验塑造的思维方式,LLM 的能力也来自两部分:预 训练所积累的世界知识与语言能力,以及后训练所固化的决策策略——后者的具体技术(如监督微调与强化 学习)将在第八章展开。
  • 上下文是 Agent 的眼睛:它不只是输入给模型的那段文本,而是 Agent 在每个决策点收到并保留的信息表示 ——来自环境的观察、用户记忆、领域知识、自身状态和任务进展。
  • 工具是 Agent 的手脚:这里的“工具”指 Agent 用来感知或改变外部世界的接口,包括工具定义、调用协议和 适配器——从预定义的工具调用到动态生成代码,从委托子 Agent 协作到主动与用户沟通。

Agent = Model + Harness
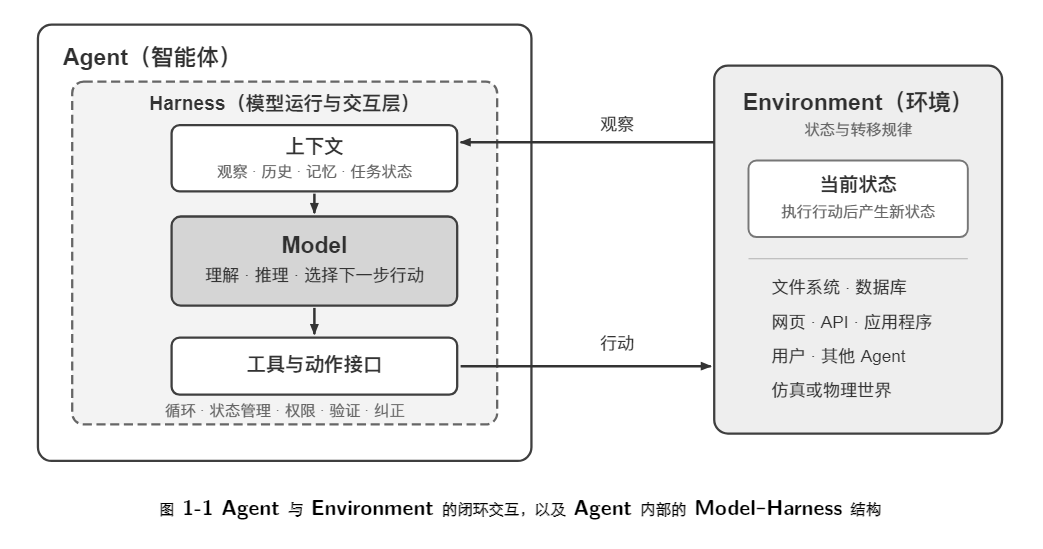
alt text

Harness

Harness 把环境返回的观察转换为模型能够处 理的上下文,再把模型选择的行动转换为对环境的工具调用。没有通过观察通道进入上下文的信息,对模型来说就 像不存在;没有被动作接口允许的操作,模型即使知道该怎么做,也只能停留在文字建议上。

Manus

合并原本分离的空间。在 Manus 出现之前,生产级 Agent 大多沿着 Deep Research(深度调研)、 Coding(代码生成)和 Computer Use(电脑操控)三条相对独立的路线发展。Manus 的突破在于率先把三者放进 同一个有广泛影响力的生产级 Agent:虚拟浏览器扩大了观察空间,文件系统、代码执行与命令行执行扩大了动作 空间。它没有仅靠替换一个更强的模型来成为通用 Agent,而是取三类 Agent 观察空间与动作空间的并集,使同一 个 Agent 能跨越原有产品边界完成任务。

OpenClaw

把接口延伸到用户的数字生活。 OpenClaw 又把这两个空间向外推进了一层。它通过用户已经在使用的 WhatsApp、Telegram、Slack、Discord、iMessage 等消息渠道接收任务和返回结果,让 Agent 可以随时随地被触达;同时采用本地 Gateway,连接 Google Drive、Notion 等云应用以及本地文件系统。这样一来,分散在不同账号与设备中的数字文件都可以在用户明确授权后进入同一个 Agent 的观察空间,并被其工具处理。相较于早期 Manus 以隔离云端沙盒为中心、往往需要上传文件或另行配置连接器的形态,本地优先的 OpenClaw 跨越了更大的数据边界。值得注意的是,Manus 后来也加入了 Google Drive 连接器和桌面端本地访问,这恰好再次说明,产品能力的演进往往就是观察空间和动作空间的演进。

这里顺便纠正一个观念:小龙虾本身不是模型、小龙虾本身不是模型、小龙虾本身不是模型!它更像是一层外置框架,去对模型塑形。你可以在小龙虾中使用各类支持的模型,但不存在 小龙虾 > gpt 之类的比较关系。

工具

只有调用了工具,Agent 才能真正读取并进行操作。这也是我认为 Agent 突飞猛进的一点:在之前,你让 AI 写文案,AI只能输出一段 markdown ,需要你自己调整为合适的格式。但现在, AI 可以直接调用工具生成pdf、pptx或你需要的格式,只要工具中有申明。许多MCP、Skill也是为了让 Agent 更好调用工具。

工具调用(Tool Calling / Function Calling)

是现代 LLM Agent 的一项核心能力,它让模型能够通过结 构化的方式调用外部工具。这种能力将 LLM 从一个纯粹的文本生成器转变为能够执行实际操作的智能系统。本书 后续统一使用“工具调用”这一术语。

工具调用的流程分为四步:首先,在上下文里告诉模型有哪些工具可用(包括名称、用途和参数);然后,模型 自主判断要不要调用工具、调用哪个、传什么参数;接着,工具执行完毕后,结果被追加到上下文中;最后,模型 据此决定下一步行动。这个循环就是后文要介绍的 ReAct 的基础。

以一个查天气的场景为例,四步流程在 API 层面的简化表示如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
第一步:声明工具 
tools: [{
name: "get_weather",
parameters: {
city: "string"
}
}]
第二步:模型决定调用
assistant: {
tool_calls: [{
function: "get_weather",
arguments: {city: " 北京"}
}]
}
第三步:结果追加到上下文
tool: {
tool_call_id: "call_1",
content: '{"temp":28,"sky":" 晴"}'
}
第四步:模型基于结果回复
assistant: {
content: " 北京今天 28°C、晴。"
}

LLM

大语言模型(Large Language Model, LLM)是 Agent 的决策核心。收到用户的请求后,它需要先解析真实 意图(用户说的往往不是他真正想要的),再将模糊或复杂的任务拆解成可执行的步骤。执行过程中它还要持续做出 判断:下一步该做什么、要不要调用工具、调哪个工具、传什么参数。这种“理解-规划-执行”的能力来自预训练所积 累的知识,是工作流和自主 Agent 都依赖的基础。

模型即 Agent:能力内化,但 Harness 仍然重要

一些先进模型通过后训练,尤其是强化学习,将工具调用策略内化为原生能力:何时调用工具、调用哪个工具、传什么参数,都可以由模型自行决定。这里需要区分“决策”和“执行”:强化学习写入模型参数的是决策策略,工具本身的实现、权限、调用循环和结果回传仍由 Agent 框架或 API 服务端完成。

模型越能自主决策,出错时的影响面也越大,因此围绕模型的 Harness 并不会消失。它负责上下文管理、工具接口、安全约束、验证和纠正,把模型能力引导成可靠的任务执行。

Agent 的学习机制:三种更新路径

Agent 的行为改变不只发生在训练阶段,可以按更新位置和持续时间分成三条路径:上下文适应是在当前任务中加入示例、状态或检索结果,立即生效但不会跨会话保留;外部产物更新是把事实写入知识文档,把策略写入 Prompt 或 Skill,把确定性约束写进程序和 Harness,能够跨任务积累且便于审计;参数更新则通过后训练改变模型本身,适合内化难以用规则表达的通用能力,但成本和部署风险更高。

上下文

从 API 的视角看,每次调用 LLM 时的上下文由以下五个部分构成:

  • 系统提示词(System Prompt):与用户每次输入的提示词不同,系统提示词由开发者编写,在整个对话过 程中保持不变,相当于 Agent 的“岗位说明书”——定义它的身份、权限和行为准则。通过提示工程(Prompt Engineering)精心设计系统提示词,我们可以塑造 Agent 的工作方式。系统提示词中还会包含跨会话保存的 用户记忆(用户偏好、历史行为、背景设定等个性化信息,详见第三章)和动态注入的环境状态。
  • 工具定义(Tool Definitions):声明 Agent 可用工具的名称、功能描述和参数格式。没有工具定义,Agent 就 无法识别和调用任何工具——消融实验(实验 1-1)将验证这一点。工具定义与系统提示词一起构成对话中保 持不变的静态前缀(这是基础模式;2026 年以来,生产框架中工具的完整 schema 也可以按需动态加载到上 下文末尾而不破坏前缀,详见第二章工具定义一节和第四章)。
  • 用户消息(User Messages):来自用户的输入。用户消息中还可能包含通过 RAG(检索增强生成,Retrieval- Augmented Generation,详见第三章)动态检索引入的外部知识——覆盖训练数据截止后的信息或私有领域 知识。
  • 模型回复(Assistant Messages):模型之前生成的回复,最多包含三个部分——思考过程(reasoning,即内 部思考链,用于保持思维的连贯性和决策的可解释性)、文本内容(content,即对用户的回复)和工具调用 请求(tool_calls,即 Agent 采取行动的方式)。在一次具体的回复中,三者不一定同时出现:例如 Agent 决定调用工具时通常只有 reasoning + tool_calls,给出最终回答时通常只有 reasoning + content。
  • 工具执行结果(Tool Results):Agent 框架执行工具后返回的结果。这些结果是 Agent 下一步思考的直接依 据,也让它能够从执行结果中学习、避免重复犯错。

前两项(系统提示词 + 工具定义)是静态前缀,后三项(用户消息 + 模型回复 + 工具执行结果)是随交互不 断增长的动态消息历史。这五个部分共同构成了 LLM 每次推理时的上下文。

消融实验

此处为了体现各模块的重要性,进行了消融实验:
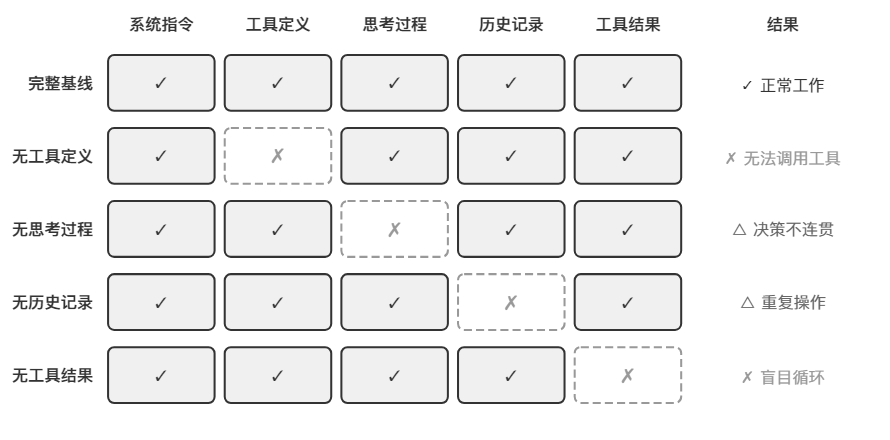
alt text

工具定义(Tool Definitions,静态前缀的一部分)是 Agent 行动能力的基础,没有它,Agent 就无法识别和调用任何工具。工具执行结果(Tool Results)是闭环控制的关 键,缺失它会导致 Agent “盲目”执行,陷入无限循环。思考过程(模型回复中的 reasoning 部分)保留了 Agent 此前做出决策的原因,使思维流程更加连贯,避免做出前后矛盾的决策。历史消息(之前轮次的用户消息、模型 回复和工具执行结果)则防止了冗余操作,保持任务执行的连贯性,避免重复犯同样的错误。

ReAct 循环

Agent 执行任务的核心模式叫做 ReAct(Reasoning + Acting)。虽然名字只体现了思考(Reasoning)和行动 (Acting)两个词,但实际循环包含三个环节:模型先思考当前应该做什么,然后调用工具行动,再观察工具返回的 结果并继续思考下一步。这个“想 → 做 → 看 → 想 → 做 → 看”的循环不断重复,直到任务完成。

Harness 工程:从“能做事”到“可靠地做事”

如果把 LLM 看作 Model,那么 Agent 边界内围绕模型运行的代码、配置和服务可以统称为 Harness。生产形态可以写成:Agent = Model + Harness,其中 Harness = 上下文管理 + 工具接口 + 约束 + 验证 + 纠正。前两项让 Agent 能理解任务并采取行动,后三项负责限制危险行为、检查结果并在失败时重试、回退或交给人处理。

Harness 不包括它所操作的环境本身:工具适配器、权限和沙箱属于 Harness,沙箱中的文件、进程、数据库和网页属于 Environment。生产系统的主要工程量往往不在调用模型,而在这些运行与治理机制上。

发展历程

提示工程(Prompt Engineering)是第一波创新——通过优化输入给模型的自然语言指令来提升输出质量。 上下文工程(Context Engineering)是第二波——人们认识到单纯优化提示词还不够,需要系统性地管理模型 能看到的所有信息(系统指令、工具定义、对话历史、外部知识)。

Harness 工程是第三波——它将视野从“模型能看到什么”进一步扩展到“Agent 如何组织模型运行并与环境交 互”,涵盖上下文与工具接口、约束机制、验证手段、反馈循环和错误恢复等 Agent 边界内、模型之外的运行与治理 机制。

随后出现的 Loop 工程(Loop Engineering)又把视野从单次运行扩展到跨轮次的持续自主运转:谁来发现下 一件该做的事、何时验证、何时才算真正完成(第十章将结合多 Agent 协作系统展开)。

2026 年 7 月,业界又开始用 Graph 工程(Graph Engineering)描述一种更高层的编排视角:把 Agent 循环、 确定性程序和人工审批组织成显式的执行图,其中节点承担具体能力,边规定路由与依赖,结构化状态沿边传递并 在关键边界处持久化。

工作流与自主 Agent

工作流把 LLM 和工具放进开发者预先定义的固定路径,适合步骤明确、合规要求严格的任务;自主 Agent 则根据环境反馈动态决定下一步,适合开放式、步骤数量难以预估的任务,但会付出更多延迟、成本和复合错误风险。实践中常把两者混合:关键边界使用确定性流程,灵活部分交给自主循环。选择顺序通常应是:先尝试单次模型调用,再考虑工作流,只有确实需要动态决策时才引入自主 Agent,并为其设置最大迭代次数、错误处理和人工检查点。

成功的 Agent 系统遵循三个核心原则

保持简单。从最简单的方案开始,只在确实必要时才增加复杂度。直接的 API 调用优于复杂的框架,清晰的代 码优于聪明的抽象。因为每多一层抽象都会成为以后调试时新的盲区。

保持透明。明确显示 Agent 的规划步骤、执行日志和决策轨迹——这不只是为了调试方便,也是让用户建立信 任的前提。因为黑箱里的错误一旦发生,外部观察者既无法定位也无法纠正。

设计好工具接口(ACI,Agent-Computer Interface)。ACI 强调的是从 Agent 视角设计接口(让 Agent 容易 理解和使用),而非传统 API 从程序员视角设计接口。工具的命名和参数要直观,容易误用的地方要从设计上让错 误无法发生——比如 SIM 卡的缺角让卡片只能从一个方向插进卡槽,避免了用户插反的错误;微波炉门没关好就 绝不加热,避免了用户开门加热的危险行为。这种“用设计消除错误”的思路,在制造业里有一个专门的术语,叫防 呆(Poka-yoke),源自丰田生产体系。设计不好的工具会让再强的模型也频繁出错——因为模型与工具之间唯一的 沟通通道就是接口本身,模糊的接口会被模型放大成系统性的错误。

护栏与安全性

护栏(Guardrails)构成了保障 Agent 行为安全可控的分层防线,可用于管理数据隐私风险(例如防止系统提 示泄露)或声誉风险(例如确保模型行为与品牌形象一致)。实践中可以先针对已识别的风险设置护栏,再在发现新 漏洞时逐步添加。本节只做高层次的概览,确立全书统一的分层骨架;具体的实现细节将在第二章(上下文层:提 示注入防护)、第四章(执行层:工具权限控制)和第五章(执行层与数据层:代码执行安全、信任边界下移)分别 展开,初次阅读无需深究。

单个护栏不太可能提供足够的保护,多个专门的护栏组合使用,才能构建出更有韧性的 Agent 系统。 护栏也存在另一类失败:误拒绝。为了降低危险请求被放行的概率,模型可能同时拒绝一部分合法但形式敏感 的任务,例如经过授权的安全测试、模型蒸馏研究。因此,护栏评估不能只测试“应当拒绝的请求是否被拦截”,还要 测试“明确允许的请求是否能够正常完成”。

设计模式

提议者—审核者(Proposer-Reviewer):产出与评判由两个不共享上下文的角色分别承担,评判方看到的是产 物本身——渲染结果、测试输出、结构化的调用参数——而不是产出方的推理过程。它成立的前提是自审不可靠:同 一个上下文中的模型难以发现自己的认知盲区,也很难判断自己是否已被注入。第三章用它更新知识,第四章用它 做工具调用的事前审批与事后验证(Sidecar 是它的一个只读变体),第五章的 PPT、视频与日志三个实验都以它 为骨架,第七章用它评估 UI,第九章用它审核更新提案,第十章讨论了它在对等协作中的形态,以及为什么不能让 同一个 Agent 自审。

渐进式披露(Progressive Disclosure):不把全部信息一次性放进上下文,而是先给一份可检索的目录,再按 需加载细节。它同时优化两件事——上下文预算与选择精度。第二章的 Agent Skills 是最典型的形态(元数据常驻、 正文按需加载),第三章的分层检索、第四章的主动工具发现与分页截断、第十章的 Agent 发现都是它的变体。 只增不改(Append-only):状态以追加的方式演进,已经写下的内容不再回头修改。换来的是可缓存、可重放、 可审计。第二章的 KV Cache 前缀稳定性是它的性能形态——改动越靠前,作废的缓存越多;第三章的事件式记忆、 第四章把新工具的 schema 追加到轨迹末尾而不是插回前缀,都是同一条纪律。

边界集 + 保留集(Boundary Set + Retention Set):任何一次修改都要同时在”它应当改变的那批样本”和”它 不应当影响的那批样本”上验证。只测前者会把过拟合当成进步,只测后者会把无效修改当成安全。第七章的回归任 务、第八章的训练与评估隔离、第九章的更新提案验证都建立在这对集合上。

最小 diff + 可回滚:每次修改尽量小、带来源、可单独回滚,而不是整体重写。它让归因成为可能——出了问 题能定位到具体哪一次改动。第三章的知识更新、第五章的代码补丁、第九章的 Prompt 与程序更新都遵循这条; 本章开头给出的三条更新路径(上下文内适应、外部产物更新、参数更新),也正是按可回滚程度从高到低排列的。
前言

这篇文章是我围绕“面向冗余机械臂规划控制的神经动力学模型”完成的一次课程文献调研。我选取了 15 篇中英文论文,时间跨度从 2008 年到 2026 年,内容覆盖逆运动学、二次规划、递归神经网络、归零神经网络、物理约束、滚动时域控制、数据驱动和任务优先级控制。

读完这些论文后,我大致得出的理解为:

1
2
把冗余机械臂的多解问题写成带约束的时变优化,
再把“求最优解”变成一个能够在线演化并收敛的神经动力系统。

技术演进大致是:

1
2
3
4
5
6
伪逆求解
→ QP 统一主任务、次级目标和关节边界
→ RNN/GNN 作为并行在线求解器
→ ZNN 利用时间导数信息减小动态滞后
→ 投影、对偶和变参数模型处理复杂约束与收敛
→ RHC、Koopman、数据驱动和分层控制扩展应用边界

这批工作共同说明神经动力学适合实时优化,但也暴露出一个明显矛盾:模型越能处理复杂约束,推导、参数和离散实现就越复杂。论文中的连续时间收敛结论,也不能自动替代实物系统上的时延、噪声和算力验证。

概念

冗余机械臂为什么会有多解

若机械臂关节自由度 n 大于末端任务空间维度 m,即 n > m,其速度级运动学通常写成:

1
ṙ = J(θ)θ̇

这是一个欠定方程。同一末端速度 ṙ 可能对应多组关节速度 θ̇。伪逆可以给出最小二范数解,但难以自然表达关节限位、避障、周期回零和任务优先级等要求。[1]

二次规划(QP)提供了更灵活的表达:用目标函数选择一组更合适的关节运动,用等式保证末端任务,用不等式表示物理边界。[2]

“神经网络”不一定需要训练

这 15 篇论文中的 RNN、GNN、ZNN 和 DNN,很多并不是依靠数据集训练权重的深度学习模型,而是由常微分方程构造的优化求解器。网络状态随时间演化,平衡点对应方程或优化问题的解。

到了数据驱动和 Koopman 路线,学习模型才真正成为核心部分:前者在线估计雅可比矩阵,后者从输入输出数据学习机械臂动力学,再把学习结果交给控制器。[11-13]

15 篇文献分别解决了什么

为了避免把文章写成摘要堆叠,我按“问题如何被建模、优化如何被求解、未知模型如何处理、多个任务如何协调”分成四组。

一、从逆运动学到带约束 QP

张泽玺等教授的综述把冗余机械臂逆运动学方法分为解析法、数值法和人工智能方法,为后续论文提供了问题地图。[1] 解析法精确但依赖具体结构;数值法通用,却需要处理奇异性和初值;人工智能方法适应性强,但通常引入训练或稳定性验证问题。

张雨浓等教授较早把平面冗余机械臂自运动写成带等式和双端约束的 QP,并用基于线性变分不等式的原对偶神经网络实时求解。[2] 这类工作确立了一个后来反复出现的套路:先决定优化什么,再讨论用哪种神经动力学模型求解。

关节漂移是周期任务中的典型问题。吕宣姣等教授在八连杆和九连杆平面机械臂上验证二次型性能指标对无偏差运动规划的作用;张智军和张雨浓则从理论和 PUMA560 仿真说明速度层与加速度层重复运动规划方案可以建立等效关系。[3-4] 这两篇论文点出,末端闭合轨迹不等于关节状态自动回到起点。

二、在线求解器如何变得更可靠

张智军等教授比较三种递归神经网络和三种离散数值方法来求解重复运动规划。[5] 论文的结果不是简单宣称 RNN 全面更好,而是给出了实际取舍:多数正常仿真条件下,神经网络更快、更准确;离散数值方法则更容易直接部署到数字计算机。

固定参数难以同时照顾初期收敛和稳态表现。VP-CDNN 使用时变参数求解带反馈的关节无漂移 QP,并在 Kinova Jaco2 上进行了物理实验。[6] 这项工作把“误差是否归零”与“关节是否回到合理构型”放进同一框架。

约束进一步复杂后,求解器出现了不同分支:

  • CCNC-QP-DNN 同时面向凸和非凸约束,并处理初始误差,但论文验证以计算机仿真为主;[7]
  • VPZND 把时变非线性等式、时变线性不等式、有界噪声和固定收敛时间放在统一框架中;[8]
  • Dini-ZNN 使用连续但不可微的投影算子,并用上右 Dini 导数处理模式切换,避免为平滑近似额外调参。[9]

这组论文展示了神经动力学研究的核心变化:关注点从“能不能解 QP”逐渐转向“面对时变、多类型约束、初始误差和噪声时还能不能稳定求解”。

三、预测控制与模型未知

Yan 等把滚动时域控制(RHC)写成凸 QP,目标同时包含跟踪误差、速度范数和加速度范数,并直接考虑角度、速度、加速度三层边界和终端等式约束,再设计 RNN 在线求解。[10] 它的价值在于引入预测窗口,但计算量和控制效果会受到窗口与离散实现影响。

Sah 等提出 Koopman-ZNN 框架:用自编码器学习低维双线性 Koopman 模型,再配合 ZNN 处理输入约束。[11] 论文报告的控制频率最高可达 800 Hz,并进行了仿真和实验。它比纯运动学 ZNN 更接近“学习模型 + 在线控制”的组合,但效果仍依赖训练数据能否覆盖真实工作区。

两篇中文论文从雅可比矩阵未知出发:

  • 刘佰阳等用梯度下降从末端速度和关节速度数据估计雅可比矩阵,并构造加速度层规划方案;[12]
  • 金龙等进一步同时控制末端位置与姿态,用四元数表示姿态,并设计神经动力学求解器。[13]

这类数据驱动方案缓解了精确 DH 参数不可得的问题,但把风险从“模型参数误差”转移到了“在线估计误差”。因此,除了跟踪精度,还需要关注激励是否充分、估计是否收敛以及闭环稳定性是否对学习误差敏感。

四、从单任务扩展到多任务

谢正泰等的综述从神经动力学、前馈神经网络、递归神经网络和强化学习四个方向回顾机器人学习与控制。[14] 它帮助我区分了两类经常混在一起的研究:一类用神经网络逼近未知函数或策略,另一类把动态网络当作优化计算过程。

在多任务控制中,谢正泰等又提出 PBRNN,通过零空间投影给末端跟踪、姿态或关节任务安排优先级;当任务总维度超过机械臂自由度时,低优先级任务会被放弃。针对优先级切换引起的控制突变,论文进一步提出带补偿项的 PSRNN,并通过仿真和物理实验验证。[15]

这项工作说明,冗余自由度并不意味着所有任务都能同时完成。任务冲突时,控制器必须明确“谁先完成、谁可以退让”,而不是把所有约束平铺后期待求解器自行化解冲突。

文献对照表

# 年份 文献简称 主要问题 方法与验证
1 2026 逆运动学方法综述 逆运动学方法如何分类 解析、数值、人工智能三类综述
2 2008 QP 自运动 关节受限下的自运动 QP + 原对偶神经网络,平面机械臂仿真
3 2012 八/九连杆无漂移 高冗余机械臂关节漂移 二次型指标,平面模型仿真
4 2013 速度/加速度层等效 不同规划层级是否等效 神经动力学分析 + PUMA560 仿真
5 2017 三种 RNN 与三种数值法 重复运动规划在线求解 仿真 + 物理实验 + 求解器对比
6 2018 VP-CDNN 关节角漂移与初始误差 变参数动态网络 + Kinova Jaco2 实验
7 2019 CCNC-QP-DNN 凸/非凸约束与初始误差 对偶网络,五类末端任务仿真
8 2023 Robust VPZND 物理约束与有界噪声 固定时间分析 + 数值/仿真验证
9 2024 Dini-ZNN 多类型约束与不可微投影 理论 + 仿真 + 机器人实验
10 2022 RNN-RHC 带预测窗口的约束跟踪 三层边界,仿真 + 实验
11 2024 Koopman-ZNN 学习动力学并实时控制 自编码器 + ZNN,仿真 + 实验
12 2023 模型未知规划 未知雅可比矩阵 梯度在线估计 + 数值仿真
13 2024 数据驱动位姿控制 未知模型下的位置与姿态 在线学习 + 四元数 + 仿真对比
14 2023 机器人学习控制综述 神经网络方法的整体分类 ND、FNN、RNN、RL 四类综述
15 2026 PBRNN/PSRNN 多任务冲突与优先级切换 零空间投影 + 补偿,仿真 + 物理实验

横向比较:几条路线分别适合什么

路线 核心思路 优点 主要风险
伪逆/数值逆解 直接求欠定运动学方程 形式直接、基线清楚 复杂边界和次级目标不易统一
QP + 原对偶/投影网络 把目标与约束统一为优化问题 约束表达灵活、适合并行求解 可行域、参数和离散化影响实现
ZNN/变参数网络 让时变误差按设计动态归零 利用导数信息,动态跟踪能力强 需要系数导数,噪声下更敏感
RHC + RNN 滚动预测并在线优化 能考虑未来输出和终端条件 预测窗口增加计算量
数据驱动/Koopman 从数据估计雅可比或动力学 减少对精确模型的依赖 训练覆盖、在线估计误差和泛化
分层控制 用零空间和优先级处理任务冲突 主次任务关系明确 优先级切换可能引起不连续

我的几点判断

1. 神经动力学的主要优势是在线优化

这批论文中最稳定的主线不是“网络能拟合复杂函数”,而是“动态系统能实时逼近时变优化问题的解”。因此,评价它们时应优先看收敛、约束、计算周期和硬件验证,而不是套用深度学习中的训练集准确率。

2. 约束完整性比单一误差数字更重要

只报告末端误差很小,并不能说明关节速度、加速度或输入始终安全。比较方案时至少要同时检查:

  • 末端跟踪误差;
  • 关节状态和控制输入是否越界;
  • 周期任务结束后是否发生关节漂移;
  • 遇到初始误差、噪声或外部干扰时是否稳定;
  • 是否有实物实验,以及控制周期是否满足实时要求。

3. 连续时间证明与数字实现之间还有距离

多数模型先在连续时间下证明收敛,再用数值积分部署。步长过大、测量噪声、高阶导数估计和通信延迟都可能改变实际表现。论文中的“全局收敛”需要连同假设一起阅读,不能脱离可行性和离散实现单独引用。

4. 当前方向正在从已知模型走向混合方法

较早工作通常假设雅可比矩阵和运动学模型准确已知;后续研究开始在线估计雅可比、学习 Koopman 模型,或者在任务层引入优先级。未来更可能出现的是模型、数据和优化的混合,而不是单一方法完全替代其他路线。

这次调研的局限

15 篇文献集中在冗余机械臂、QP 与神经动力学这条研究线上,其中多篇来自相近研究团队。它们适合呈现技术演进,但不足以代表整个机器人规划控制领域。本文也没有覆盖基于采样的路径规划、完整动力学控制、碰撞检测和大规模强化学习等路线。

总结

从这 15 篇文献可以看到,冗余机械臂规划控制的核心一直没有变:在完成末端任务的同时,合理使用多出来的自由度。变化的是问题表达和求解方式——从伪逆到 QP,从固定参数动态网络到 ZNN、投影与变参数模型,再到预测控制、数据驱动和任务分层。

对我来说,这次调研最大的收获是建立了一个判断框架:看到新的神经动力学模型时,不只看它的名字和收敛速度,而是继续追问它解决了哪类约束、依赖哪些模型信息、在什么硬件上验证,以及连续时间结论能否落到实际控制周期中。

参考文献

[1] 张泽玺, 熊根良, 高延峰, 张华. 冗余机械臂逆运动学求解方法综述[J]. 机械设计与制造, 2026(1): 222-230.

[2] 张雨浓, 谭志国, 杨智, 蔡炳煌. 基于二次型规划的平面冗余机械臂的自运动[J]. 机器人, 2008, 30(6). DOI: 10.13973/j.cnki.robot.2008.06.017.

[3] 吕宣姣, 张雨浓, 杨智. 平面八连杆和九连杆机械臂关节角无偏差运动规划验证[J]. 中国科技信息, 2012(23).

[4] 张智军, 张雨浓. 重复运动速度层和加速度层方案的等效性[J]. 自动化学报, 2013, 39(1): 88-91. DOI: 10.3724/SP.J.1004.2013.00088.

[5] Z. Zhang, L. Zheng, J. Yu, Y. Li, and Z. Yu, “Three Recurrent Neural Networks and Three Numerical Methods for Solving a Repetitive Motion Planning Scheme of Redundant Robot Manipulators,” IEEE/ASME Transactions on Mechatronics, vol. 22, no. 3, pp. 1423-1434, 2017. DOI: 10.1109/TMECH.2017.2683561.

[6] Z. Zhang, T. Fu, Z. Yan, L. Jin, L. Xiao, Y. Sun, Z. Yu, and Y. Li, “A Varying-Parameter Convergent-Differential Neural Network for Solving Joint-Angular-Drift Problems of Redundant Robot Manipulators,” IEEE/ASME Transactions on Mechatronics, vol. 23, no. 2, pp. 679-689, 2018. DOI: 10.1109/TMECH.2018.2799724.

[7] Z. Zhang, S. Chen, and S. Li, “Compatible Convex-Nonconvex Constrained QP-Based Dual Neural Networks for Motion Planning of Redundant Robot Manipulators,” IEEE Transactions on Control Systems Technology, vol. 27, no. 3, pp. 1250-1258, 2019. DOI: 10.1109/TCST.2018.2799990.

[8] M. Zhang, W. Tong, P. Li, Y. Hou, X. Xu, L. Zhu, and E. Q. Wu, “Robust Neural Dynamics Method for Redundant Robot Manipulator Control With Physical Constraints,” IEEE Transactions on Industrial Informatics, vol. 19, no. 12, pp. 11721-11731, 2023. DOI: 10.1109/TII.2023.3249768.

[9] W. Li and Y. Pan, “A Dini-Derivative-Aided Zeroing Neural Network for Time-Variant Quadratic Programming Involving Multi-Type Constraints With Robotic Applications,” IEEE Transactions on Neural Networks and Learning Systems, vol. 35, no. 9, pp. 12482-12493, 2024. DOI: 10.1109/TNNLS.2023.3263263.

[10] J. Yan, L. Jin, Z. Yuan, and Z. Liu, “RNN for Receding Horizon Control of Redundant Robot Manipulators,” IEEE Transactions on Industrial Electronics, vol. 69, no. 2, pp. 1608-1618, 2022. DOI: 10.1109/TIE.2021.3062257.

[11] C. K. Sah, R. Singh, and J. Keshavan, “Real-Time Constrained Tracking Control of Redundant Manipulators Using a Koopman-Zeroing Neural Network Framework,” IEEE Robotics and Automation Letters, vol. 9, no. 2, pp. 1732-1739, 2024. DOI: 10.1109/LRA.2024.3349966.

[12] 刘佰阳, 郑宇, 魏琳, 刘梅, 金龙. 面向模型未知的冗余机器人运动规划方案[J]. 兰州大学学报(自然科学版), 2023, 59(4): 506-511. DOI: 10.13885/j.issn.0455-2059.2023.04.011.

[13] 金龙, 张凡, 刘佰阳, 郑宇. 基于数据驱动的冗余机器人末端执行器位姿控制方案[J]. 自动化学报, 2024, 50(3): 518-526. DOI: 10.16383/j.aas.c230273.

[14] 谢正泰, 樊佳亮, 刘梅, 金龙. 基于神经网络的机器人学习与控制:回顾与展望[J]. 信息与控制, 2023, 52(1): 37-58. DOI: 10.13976/j.cnki.xk.2023.2428.

[15] 谢正泰, 吴新博, 金龙. 基于任务优先级的冗余机械臂分层控制[J]. 中国科学: 信息科学, 2026, 56(6). DOI: 10.1360/SSI-2025-0383.

前言

这篇文章来自我的一次课程文献精读,论文题目是 Novel Snap-Layer MMPC Scheme via Neural Dynamics Equivalency and Solver for Redundant Robot Arms With Five-Layer Physical Limits。

它用同一套 Zhang neural dynamics equivalency(ZNDE)完成了三件事:

  1. 把“关节尽量回到初始位置”的最小运动目标提升到 snap 层;
  2. 把角度、速度、加速度、jerk 和 snap 五层限制统一成 snap 的上下界;
  3. 把末端路径跟踪条件提升为 snap 层等式约束。

三部分最后组成一个标准二次规划,并由 projection neural dynamics(PND)在线求解。论文在六自由度平面冗余机械臂上完成了仿真,但没有实物实验,也没有把力矩、能耗和噪声纳入验证。因此,它证明的是一种运动学层面的可行方案,不等同于已经可部署的工业控制器。

问题

设机械臂有 n 个关节,而末端任务空间只有 m 维。当 n > m 时,同一个末端位姿通常对应多组关节构型,这就是冗余带来的多解性。

冗余不是缺点。多出来的自由度可以用于避障、避开关节极限或减少关节运动,但也让控制器需要同时回答四个问题:

  • 末端能否准确跟踪给定路径;
  • 多组可行关节运动中应该选哪一组;
  • 关节状态能否始终留在物理边界内;
  • 优化问题能否随机器人运动实时求解。

论文选择的次级目标是 minimum motion:完成路径跟踪后,让各关节尽量回到初始角度。这个目标可以减少不必要的关节位移,也能避免周期任务中的关节漂移。

为什么要到 snap 层

从关节角 θ 开始连续求导,可以得到不同规划层级:

层级 量 与关节角的关系
角度层 θ 关节位置
速度层 θ̇ 一阶导数
加速度层 θ̈ 二阶导数
jerk 层 θ⃛ 三阶导数
snap 层 θ⁽⁴⁾ 四阶导数

不同资料对 jerk 和 snap 的中文译名并不完全一致,所以后文保留英文名。直观上,若 jerk 仍然发生突变,机械臂运动就还不够平滑;把决策变量提升到 snap 层,可以直接约束这种变化。

不过,“层级更高”不等于真实设备一定更平滑。论文在连续时间运动学模型中说明了高阶轨迹的连续性,真实机械臂还会受到采样周期、传感噪声、执行器带宽和动力学的影响。

ZNDE:把低层目标搬到 snap 层

论文希望关节角回到初始状态 θ₀,最直接的误差是:

1
e = θ - θ₀

ZNDE 的做法不是直接令 e = 0,而是规定误差满足稳定的一阶动态:

1
ė = -λe,  λ > 0

把这一操作连续使用四次,相当于对误差施加 (D + λ)⁴,其中 D 表示时间微分算子:

1
2
3
(D + λ)⁴(θ - θ₀) = 0

θ⁽⁴⁾ + 4λθ⃛ + 6λ²θ̈ + 4λ³θ̇ + λ⁴(θ - θ₀) = 0

系数 1、4、6、4、1 正好来自二项式展开。这样,原本位于角度层的最小运动目标就有了 snap 层表达。

论文据此构造性能指标:

1
2
3
min  1/2 ||θ⁽⁴⁾||² + pₛᵀθ⁽⁴⁾

pₛ = 4λθ⃛ + 6λ²θ̈ + 4λ³θ̇ + λ⁴(θ - θ₀)

第一项限制 snap 的大小,线性项则让关节状态沿着误差归零动态返回初始构型。因此,这不是单纯的 minimum snap norm,而是同时包含“高阶平滑”和“最小运动”的目标。

五层约束如何变成一层

原始物理限制分布在五个层级:

1
2
3
4
5
a⁻ ≤ θ ≤ a⁺
v⁻ ≤ θ̇ ≤ v⁺
α⁻ ≤ θ̈ ≤ α⁺
j⁻ ≤ θ⃛ ≤ j⁺
s⁻ ≤ θ⁽⁴⁾ ≤ s⁺

难点在于,二次规划只有一个决策变量 θ⁽⁴⁾,不能直接把不同阶的状态都写成它的简单上下界。

论文采用的不等式型 ZNDE 可以先把某一层边界变成它的导数边界:

1
κ(x⁻ - x) ≤ ẋ ≤ κ(x⁺ - x),  κ > 0

当 x 接近上界时,允许的正向变化率会逐渐收紧;接近下界时,允许的负向变化率也会收紧。对角度约束重复四次、速度约束重复三次、加速度约束重复两次、jerk 约束重复一次,就能把它们全部提升到 snap 层。

最后只需取所有下界中的最大值和所有上界中的最小值:

1
2
3
4
lₛ = max{各层转换得到的下界}
uₛ = min{各层转换得到的上界}

lₛ ≤ θ⁽⁴⁾ ≤ uₛ

这一步非常关键:五组异构约束没有被丢掉,而是变成了当前时刻对 snap 最严格的安全包络。

路径跟踪约束

机械臂的正运动学可以写成:

1
f(θ) = r

其中 r 是末端位置,f(·) 是从关节空间到任务空间的非线性映射。对路径跟踪误差应用四次 ZNDE,并整理各阶雅可比矩阵项,论文得到 snap 层等式约束:

1
J(θ)θ⁽⁴⁾ = bₛ

bₛ 包含期望路径的四阶导数、雅可比矩阵及其时间导数,以及用于抑制累计跟踪误差的反馈项。完整展开式很长,但它的作用很明确:无论冗余自由度如何被次级目标利用,末端路径跟踪仍然是必须满足的主任务。

最终二次规划与 PND 求解器

目标、等式约束和统一边界合在一起后,问题变成:

1
2
3
4
min  1/2 θ⁽⁴⁾ᵀθ⁽⁴⁾ + pₛᵀθ⁽⁴⁾

s.t. J(θ)θ⁽⁴⁾ = bₛ
lₛ ≤ θ⁽⁴⁾ ≤ uₛ

这是一个带等式和盒约束的时变二次规划。PND 求解器把原变量、对偶变量和投影算子组合成连续时间动态系统:当状态越过可行域时,投影会把它拉回边界;当动态系统收敛时,其平衡点对应二次规划的最优解。

论文给出了全局收敛分析,但这个结论带有前提:当前二次规划需要存在最优解,连续时间模型及相关参数也要满足推导条件。工程实现时还要把连续系统离散化,这部分不能只靠理论收敛性替代验证。

实验到底验证了什么

论文使用六自由度平面冗余机械臂进行仿真,每个连杆长度为 1 m,主要参数为 δ = 10⁴、ς = 10¹⁰、λ = 2、κ = 2、ν = 3。

与 jerk 层 MMPC 对比

第一组实验让末端跟踪星形路径:

  • 在宽松边界下,两种 MMPC 都能完成任务,snap 层方案最大位置误差约为 10⁻⁷ m 量级,jerk 层方案约为 10⁻⁶ m 量级;
  • 将第一个关节的 snap 上限收紧到 0.066 rad/s⁴ 后,snap 层方案仍保持在边界内;
  • 将第一个关节的 jerk 上限收紧到 0.0445 rad/s³ 后,snap 会提前调整,使 jerk 不越界。

这组实验的结论是 snap 层方案确实能显式处理第五层边界;jerk 层方案本身没有 snap 约束入口。

与 minimum snap norm 对比

第二组实验让末端跟踪 nephroid 路径,并与只最小化 snap 范数的 MSN 方案比较:

指标 Snap-layer MMPC MSN
位置误差 始终低于 1.569 × 10⁻⁷ m 接近 2.342 × 10⁻³ m
任务结束时关节速度 趋近于 0 没有全部归零
任务结束时关节位移 趋近于 0 仍有明显偏移

这里需要避免一个误读:四个数量级的误差差距不能简单归因于“用了 snap”。两种方案的目标和反馈结构不同,MMPC 的等式约束中包含误差反馈,而 MSN 只强调 snap 范数。实验说明完整 MMPC 架构更有效,并没有单独隔离每个设计因素的贡献。

我认为这篇论文的价值与局限

值得学习的地方

  • 建模统一:目标、等式约束和不等式约束都由 ZNDE 推导,逻辑非常完整;
  • 约束表达清楚:不同物理层级最终变成一个可直接求解的盒约束;
  • 对比有针对性:jerk 层基线检验约束层数,MSN 基线检验最小运动目标;
  • 问题形式标准:最终仍是二次规划,便于与其他在线求解器比较。

仍需补足的地方

  • 实验只覆盖平面六自由度模型,没有三维机械臂和实物验证;
  • 研究停留在运动学层,没有加入力矩、负载和驱动器饱和等动力学限制;
  • 高阶路径导数、雅可比导数和状态估计在噪声下可能不稳定,论文没有给出噪声实验;
  • “最小运动”被解释为节能动机,但论文实际比较的是关节位移,没有直接测量能量或功率;
  • 参数如何系统选取、离散步长如何影响稳定性,仍缺少工程层面的指导。

总结

这篇论文通过 ZNDE 把最小运动目标、末端跟踪和五层物理边界全部提升到 snap 层,再用 PND 求解统一的时变二次规划。

读完之后,我更关注的不是导数层数本身,而是这种“先统一问题表达,再设计在线求解器”的思路。它把复杂约束整理得很干净,也同时提醒我:仿真中的高阶连续性、约束满足和极小误差,距离真实机械臂上的可靠运行仍有一段路。

老师在听完汇报后指出:提升到 snap 层确实能提升精度,但对设备的要求也更大,目前很少会运用到实际生产中,更多是作为研究。

参考文献

[1] Z. Tang, Y. Zhang, and L. Ming, “Novel Snap-Layer MMPC Scheme via Neural Dynamics Equivalency and Solver for Redundant Robot Arms With Five-Layer Physical Limits,” IEEE Transactions on Neural Networks and Learning Systems, vol. 36, no. 2, pp. 3534-3547, 2025. DOI: 10.1109/TNNLS.2024.3351674.

开发工具和平台

开发微信小程序,有一些刚需的网站和工具。

微信开发者平台

微信公众平台是小程序管理入口。注册、认证、备案、成员管理、服务器域名配置、版本管理和审核发布都在这里完成。开发前建议先检查request、uploadFile等合法域名是否已经配置,否则真机环境很容易出现请求失败。

微信开发者工具用来编写、预览、调试和上传小程序代码。模拟器适合快速看页面效果,但部分能力仍要以真机为准;遇到网络请求、支付、登录等问题时,最好结合调试面板和手机端表现一起排查。

微信支付商户平台

微信支付商户平台用于申请和管理商户号、API密钥、证书、退款、账单等。小程序支付还需要把小程序AppID与商户号绑定,否则前端即使写对了调用参数,也可能因为权限问题拉不起支付。

微信支付与支付宝支付

这里说的“原生支持”,指的是小程序运行在微信生态内时,前端能直接调起对应支付方式的能力。微信小程序不能直接调起支付宝支付;反过来,支付宝小程序也不能直接调起微信支付。聚合支付本质上是通过平台侧封装或跳转方案来统一入口,是否适用要看业务形态和平台规则。

如果你不打算使用易支付/聚合支付(已经由其他平台封装好,支持微信/支付宝/银行卡等多种支付,优点是支持多平台,一键引入,缺点是平台会额外抽成),那么需要注意:微信小程序原生不支持支付宝支付。也就是说,如果你同时需要微信支付和支付宝支付,又不想被抽成,最好的办法是做成两套系统,分别在微信和支付宝上线。

微信支付

需要的参数极多

相比于支付宝,微信小程序的支付功能开发更为繁琐,且需要完成小程序认证或关联已认证的主体。微信认证费用通常为300元/年。

具体需要的参数见文档。

沙箱被禁止

微信官方取消了沙箱,支付等微信API功能无法像普通接口那样只在开发工具里完整模拟测试。

实际验证时,可以先在微信开发者工具中选择上传代码,然后在微信公众平台把这个开发版本设置为体验版,再用手机扫码进入体验版进行真机测试。此时要注意小程序与商户号是否已绑定、交易类小程序是否按要求接入订单发货管理等条件,否则可能出现支付权限受限的问题。

由于测试走的是真实支付链路,建议准备小额商品,并保留订单号方便后续查单和退款。

微信审核

当你的小程序做好之后,需要在微信公众平台进行审核。

在审核时我被卡了一道,微信要求小程序中不能出现微信、微信logo等。

大家在提交时一定要先看审核要求再提交。

另外,涉及支付、内容展示、用户信息获取的功能,通常还要准备好对应的资质说明和页面入口。审核被驳回时不要急着反复重提,先仔细阅读驳回原因,对照规范修改后再提交会更省时间。

在大二暑假,我在一家小公司实习了一个半月,接触了实际开发后,可以说是受益匪浅,对计算机软件的理解有所提升。

系统设计

管理员权限

一个完善的产品应该给非专业管理员留下足够的管理空间。

在我第一次做项目时,我更注重于系统的可行性,但忽略了客户并不是专业人员。我眼中简单的操作并不适合他们进行管理。在沟通后,我在后台加入了大量供管理员修改的权限。

如:管理员可以调整页面的布局、决定什么能够展示,什么不能展示、新增或修改法务文件等。

系统的后续可修改性

在早期设计时,可能有些功能是不必要的,但我们仍应该将这些变量纳入考虑的范围中。

这样,当相关功能需要拓展时,就能更加游刃有余的应对。

git管理

一次我将修改提交后,提醒运维组员就走了。第二天队友跟我说自己搞砸了,希望我重新提交一遍。我查了git记录后发现他和往常一样拉取了远程仓库,但我提的新功能都没有出现。

最后我排查原因时发现,是因为我在提交时没有修改代理端口,导致代码实际上没有推送到远程仓库。

这件事也让我意识到,“本地已经 commit”并不等于“远端已经更新”。关键改动推送后,最好确认远端分支的最新提交哈希已经变化,再通知其他人拉取代码。

线上与开发环境

在本地能运行的代码不一定能在线上环境正常工作。

在一次任务中,我实现了一个功能:统计商品点击量并进行排名。在开发环境的测试是没有问题的,但部署后客户却表示没有统计点击量。

通过浏览器网络追踪,我发现接口没有被触发,在网络层上根本找不到这个请求。

结合之前的经验,我判断问题的原因是线上环境没有申请SSL证书,导致浏览器认为当前环境不安全,自动拦截了相关请求。

安全重于一切

网络攻击的方式多种多样:SQL注入、供应链投毒(我记得这个很频繁,APIFox就中招过),很难做到绝对安全,但我们应该尽力保证系统的安全性,让破解成本高于对方攻击成功的利润。

测试要涵盖各种情况

在编写代码和测试时一定要考虑到所有情况。

比如用户注册时的昵称,一定要限长。按正常人的思维,用户名一般都不会太长,但这不代表这种情况不会发生。

开发工具

开源项目

若依

二开神器,地址

若依是一套比较成熟的Java后台管理系统脚手架,内置用户、角色、菜单、部门、字典、日志、定时任务等常见后台功能,也提供代码生成器。对于中小型管理系统来说,很多基础模块不需要从零写,直接基于它做二次开发,可以省下大量前期搭建时间。

我实习时接触的这个ruoyi-vue-pro,是在若依基础上扩展出来的版本,功能比官方版更丰富,比如多租户、支付、商城、工作流等模块都有对应实现。它的优点是生态和资料比较多,遇到问题时更容易找到参考;缺点是引入的功能多,结构也更重,实际使用时最好按业务裁剪依赖。

各类SDK

如 WxJava

WxJava是一个封装了微信开放能力的Java SDK,覆盖公众号、小程序、微信支付、开放平台和企业微信等常用场景。它把access_token管理、签名、请求发送和结果解析这些重复工作封装好了,开发者可以直接调用对应的Service完成登录、获取手机号、下单、退款等操作。

以小程序支付为例,自己对接微信API需要处理证书、签名、回调验签等细节;使用WxJava后,业务代码只需要准备好商户号、订单号、金额和openid等参数,再调用支付服务生成调起支付的参数即可。这样不仅开发速度快,也能减少手写协议时的低级错误。

Docker

我本地的MySQL是5.7的,但上线要求是8.0。如何在保持本地不做修改的同时测试8.0环境下的程序运行?这正是Docker解决的问题。

例如可以用一个独立的容器启动 MySQL 8.0,把端口映射到本地,再把应用的连接信息指向这个容器。这样既不会污染本机的 MySQL 5.7 环境,也能提前暴露不同数据库版本带来的 SQL 兼容性问题。

1Panel

相较于宝塔,我认为1Panel的开源属性和容器化管理体验更符合我的需求。它可以直接管理Docker容器、镜像、网络和卷,也能配置网站、反向代理与SSL证书,让本地测试环境和线上部署环境更容易保持一致。

AI使用

一定要人为检查

在使用agent开发时,使用较强的模型、配置skill等方法可以提高AI开发的正确率,但是仍然会有风险,必须要进行人为校验。代码可以由AI开发,但提交在人,要为自己提交的代码负责。

我定义了一个Spring Boot的skill,每当有任务时,必须要跑JUnit和mvn test,全部成功后才能结束任务,有时候一轮任务需要跑70~90个test,人工校验和测试都没有出现问题。因此我逐渐放松了审查,一些简单的任务直接让agent去实现。

但有一天,客户突然@我,询问站中查询的商品只有24条,怎么看到剩余的商品。我复现后理解去审查代码,发现分页功能只留了接口占位,没有实际实现。这一块我没有做代码审查,测试时本地数据量小,没有触发分页,导致这个问题直接暴露给了客户。

逻辑缺失问题

新增一个排行的功能,ai返回了商品的id。但搜索界面不支持通过id进行搜索,导致实际上排行是失败的,因为客户仍不能知道排行上的商品具体是什么。

skill的去留

现在的一些旗舰模型,如gpt5.6-sol、claude ops5等综合能力已经很强,已经不太需要skill来指导它们怎么做任务。

我的想法是:现在可以放弃那些简单的,只是指导ai怎么进行常规任务的skill,而留下那些用于专业任务特化、优化人机交互(JavaGuide在一篇公众号中推荐了)的skills。

之前在测试一个新模型时,我给它发布了一个简单的代码阅读任务,目标是我的一个SSM系统。但却触发了我Vivado的skill,这样反而会对agent的工作起反作用。所以我认为,skill在精不在多,应该有选择性的保留skill。

codegraph

codegraph是我比较推荐的一个MCP。它可以把项目中的类、方法、调用关系等建立成索引,帮助agent快速定位符号、分析依赖和理解代码结构,而不需要在每次任务里盲目搜索整个仓库。

对于较大的Java后端项目来说,这类索引型MCP尤其适合配合AI使用:先让agent通过codegraph找到入口方法和上下游关系,再阅读相关代码并执行修改,能明显减少误改范围过大的情况。

前言

这是《SQL必知必会》学习随笔系列的进阶篇,承接基础篇的内容,主要聚焦于数据库性能优化相关的知识点。

进阶篇的核心内容包括:

  • 数据库调优:从多个维度分析如何提升数据库性能
  • 范式与反范式:理解数据库设计原则及其权衡
  • 索引原理与应用:深入理解索引的底层实现和使用场景
  • 锁机制:掌握不同粒度和类型的锁
  • 性能优化实战:使用慢查询日志、EXPLAIN等工具定位和解决性能问题

如果你还没有阅读基础篇,建议先从基础篇开始,那里介绍了SQL的基本概念和MySQL的执行流程。

数据库调优

调优方向

  1. 用户的反馈
  2. 日志分析
  3. 服务器资源使用监控
  4. 数据库内部状况监控

调优维度

选择适合的DBMS

列式存储数据库可以大幅度降低系统的I/O,适合于分布式文件系统和OLAP,但不适用于数据需要频繁增删改的场景。

优化表设计

  1. 表结构要尽量遵循第三范式的原则(关于第三范式,我在后面章节会讲)。这样可以让数据结构更加清晰规范,减少冗余字段,同时也减少了在更新,插入和删除数据时等异常情况的发生。
  2. 如果分析查询应用比较多,尤其是需要进行多表联查的时候,可以采用反范式进行优化。反范式采用空间换时间的方式,通过增加冗余字段提高查询的效率。
  3. 表字段的数据类型选择,关系到了查询效率的高低以及存储空间的大小。一般来说,如果字段可以采用数值类型就不要采用字符类型;字符长度要尽可能设计得短一些。针对字符类型来说,当确定字符长度固定时,就可以采用CHAR类型;当长度不固定时,通常采用VARCHAR类型。

优化逻辑查询

SQL查询优化,可以分为逻辑查询优化和物理查询优化。逻辑查询优化就是通过改变SQL语句的内容让SQL执行效率更高效,采用的方式是对SQL语句进行等价变换,对查询进行重写。重写查询的数学基础就是关系代数。

SQL的查询重写包括了子查询优化、等价谓词重写、视图重写、条件简化、连接消除和嵌套连接消除等。

EXISTS子查询和IN子查询时,会根据小表驱动大表的原则选择适合的子查询。在WHERE子句中会尽量避免对字段进行函数运算,它们会让字段的索引失效。

假设我想对商品评论表中的评论内容进行检索,查询评论内容开头为abc的内容都有哪些,如果在WHERE子句中使用了函数,语句就会写成下面这样:

1
SELECT comment_id, comment_text, comment_time FROM product_comment WHERE SUBSTRING(comment_text, 1,3)='abc'

我们可以采用查询重写的方式进行等价替换:

1
SELECT comment_id, comment_text, comment_time FROM product_comment WHERE comment_text LIKE 'abc%'

在数据量大的情况下,第二条SQL语句的执行时间为前者的1/10。

范式

范式-3NF

这个算是数据库系统原理必学内容了,我简单说一下我的理解。

首先,从1NF -> 到 3NF 是逐级递进的, 2NF 包含了1NF的特性,而 3NF 又包含了 2NF 的特性.作为一种约束来说,1NF 对数据库的约束性最弱, 3NF 对数据库的约束最强。

在理解范式之前,需要先了解几个基本概念:

  • 候选键(Candidate Key):能够唯一标识一条记录的最小属性集
  • 主属性:包含在任一候选键中的属性
  • 非主属性:不包含在任何候选键中的属性
  • 函数依赖:如果通过属性A可以唯一确定属性B,则称B函数依赖于A,记作A→B
  • 完全函数依赖:如果A→B,且A的任何真子集都不能决定B,则称B完全函数依赖于A
  • 传递依赖:如果A→B,B→C,且B不依赖于A,则称C传递依赖于A

基于这些概念,三个范式可以这样理解:

1NF(第一范式):每个字段都是原子性的,不可再分。

2NF(第二范式):在1NF的基础上,非主属性完全函数依赖于候选键(消除了非主属性对候选键的部分依赖)。

3NF(第三范式):在2NF的基础上,非主属性不传递依赖于候选键(消除了非主属性对候选键的传递依赖)。

但是,3NF仍是有问题的。

3NF存在的问题:

即使满足了3NF,仍然可能存在主属性对候选键的部分依赖或传递依赖。例如,在某些情况下,一个主属性可能依赖于候选键的一部分,或者通过其他主属性传递依赖于候选键,这会导致数据冗余和更新异常。

为了解决这个问题,人们提出了一种新的范式:巴斯-科德范式,即BCNF。

BCNF(Boyce-Codd范式):在3NF的基础上消除了主属性对候选键的部分依赖或者传递依赖关系。简单来说,就是要求每个决定因素都必须是候选键。

反范式设计

范式为数据库提供了约束规则,这避免了许多问题,但这也对性能造成了一定影响。

反范式就是相对范式化而言的,允许少量的冗余,通过空间来换时间。

反范式的适用情况

当冗余信息有价值或者能大幅度提高查询效率的时候,如:

订单中的收货人信息,包括姓名、电话和地址等。每次发生的订单收货信息都属于历史快照,需要进行保存,但用户可以随时修改自己的信息,这时保存这些冗余信息是非常有必要的。

索引

简而言之,索引就是帮助数据库管理系统高效获取数据的数据结构。好比一本书的目录,它可以帮我们快速进行特定值的定位与查找,从而加快数据查询的效率。

不适用索引的场景

作为一种数据结构,索引本身也会占据存储空间.因此,在一些情况下,索引对搜素速率的优化比不上自己对性能的影响。这个时候我们就不能建立索引。

  1. 数据表中的数据行数比较少的情况下,比如不到1000行。

数据库本身查询速率就很高,千条数据不会对数据库产生压力,也就不需要用索引优化。

  1. 数据重复度大,比如高于10%的时候。

性别只分为男女。假设男女数量相同,如果想要在100万行数据中查找性别为男的数据,一旦创建了索引,你需要先访问50万次索引,然后再访问50万次数据表,

索引的分类

按属性的类型分类

聚集索引:属性为主键。

非聚集索引:属性不为主键。

聚集索引比使用非聚集索引的查询效率略高,通常使用聚集索引。

按属性的数量分类

单一索引:索引列为一列时为单一索引。

联合索引:多个列组合在一起创建的索引叫做联合索引。

联合索引的最左原则

在使用联合索引(复合索引)时,查询条件必须从索引的最左列开始,并且连续匹配,索引才能被有效利用。

当遇到范围查询(>、<、between、like)就会停止匹配。

根据这个特点,在设计索引时,应该注意:

  1. 区分度高的列放左边:优先将选择性(cardinality)高的列放在前面
  2. 等值查询在前,范围查询在后:
1
2
3
-- 推荐顺序: (status, create_time)
-- 而非: (create_time, status)
WHERE status = 1 AND create_time > '2024-01-01'
  1. 尽量使用覆盖索引:减少回表操作
  2. 避免索引列参与运算:保持索引列”纯净”
  3. 用 EXPLAIN 验证:
1
EXPLAIN SELECT * FROM user WHERE a = 1 AND b = 2;

索引的底层

不想看优化过程可以直接看B=树。

二叉树

二叉树是一种常见的树形存储结构,时间复杂度为O(log2n),它的特点是:

  • 如果key大于根节点,则在右子树中进行查找;
  • 如果key小于根节点,则在左子树中进行查找;
  • 如果key等于根节点,也就是找到了这个节点,返回根节点即可。

但它有一个漏洞:

如果构造出来的树是链表型的,那么时间复杂度会退化为O(n).如果用二叉树作为索引的实现结构,会让树变得很高,增加硬盘的I/O次数,所以我们不使用这种结构。

B树(平衡的多路搜索树)

它的每一个节点最多可以包括M个子节点,M称为B树的阶。

  • 根节点的儿子数的范围是[2,M]。
  • 每个中间节点包含k-1个关键字和k个孩子,孩子的数量=关键字的数量+1,k的取值范围为[ceil(M/2), M]。
  • 叶子节点包括k-1个关键字(叶子节点没有孩子),k的取值范围为[ceil(M/2), M]。
  • 假设中间节点节点的关键字为:Key[1], Key[2], …, Key[k-1],且关键字按照升序排序,即Key[i]<Key[i+1]。此时k-1个关键字相当于划分了k个范围,也就是对应着k个指针,即为:P[1], P[2], …, P[k],其中P[1]指向关键字小于Key[1]的子树,P[i]指向关键字属于(Key[i-1], Key[i])的子树,P[k]指向关键字大于Key[k-1]的子树。
  • 所有叶子节点位于同一层。

B+树

B+树基于B树做出了改进,主流的DBMS都支持B+树的索引方式,比如MySQL。B+树和B树的差异在于以下几点:

  • 有 k 个孩子的节点就有k个关键字。也就是孩子数量=关键字数,而B树中,孩子数量=关键字数+1。
  • 非叶子节点的关键字也会同时存在在子节点中,并且是在子节点中所有关键字的最大(或最小)。
  • 非叶子节点仅用于索引,不保存数据记录,跟记录有关的信息都放在叶子节点中。而B树中,非叶子节点-既保存索引,也保存数据记录。
  • 所有关键字都在叶子节点出现,叶子节点构成一个有序链表,而且叶子节点本身按照关键字的大小从小到大顺序链接。

B+树和B树有个根本的差异在于,B+树的中间节点并不直接存储数据。这样的好处是:

  1. B+树查询效率更稳定。因为B+树每次只有访问到叶子节点才能找到对应的数据,而在B树中,非叶子节点也会存储数据,这样就会造成查询效率不稳定的情况,有时候访问到了非叶子节点就可以找到关键字,而有时需要访问到叶子节点才能找到关键字。

  2. B+树的查询效率更高,这是因为通常B+树比B树更矮胖(阶数更大,深度更低),查询所需要的磁盘I/O也会更少。同样的磁盘页大小,B+树可以存储更多的节点关键字。

  3. 在查询范围上,B+树的效率也比B树高。这是因为所有关键字都出现在B+树的叶子节点中,并通过有序链表进行了链接。而在B树中则需要通过中序遍历才能完成查询范围的查找,效率要低很多。

哈希索引

用Hash进行检索效率非常高,逻辑为:

值key通过Hash映射找到桶bucket。桶(bucket)指的是一个能存储一条或多条记录的存储单位。一个桶的结构包含了一个内存指针数组,桶中的每行数据都会指向下一行,形成链表结构,当遇到Hash冲突时,会在桶中进行键值的查找。

Hash冲突

如果桶的空间小于输入的空间,不同的输入可能会映射到同一个桶中,这时就会产生Hash冲突,如果Hash冲突的量很大,就会影响读取的性能。

通常Hash值的字节数比较少,简单的4个字节就够了。在Hash值相同的情况下,就会进一步比较桶(Bucket)中的键值,从而找到最终的数据行。

Hash值的字节数多的话可以是16位、32位等,比如采用MD5函数就可以得到一个16位或者32位的数值,32位的MD5已经足够安全,重复率非常低。

哈希索引与B+树索引的区别

  1. Hash索引不能进行范围查询,而B+树可以。这是因为Hash索引指向的数据是无序的,而B+树的叶子节点是个有序的链表。
  2. Hash索引不支持联合索引的最左侧原则(即联合索引的部分索引无法使用),而B+树可以。对于联合索引来说,Hash索引在计算 Hash 值的时候是将索引键合并后再一起计算 Hash 值,所以不会针对每个索引单独计算Hash值。因此如果用到联合索引的一个或者几个索引时,联合索引无法被利用。
  3. Hash索引不支持ORDER BY排序,因为Hash索引指向的数据是无序的,因此无法起到排序优化的作用,而B+树索引数据是有序的,可以起到对该字段ORDER BY排序优化的作用。同理,我们也无法用Hash索引进行模糊查询,而B+树使用LIKE进行模糊查询的时候,LIKE后面前模糊查询(比如%开头)的话就可以起到优化作用。

索引的使用

什么时候创建索引

  1. 字段的数值有唯一性的限制,比如用户名
  2. 频繁作为WHERE查询条件的字段,尤其在数据表大的情况下
  3. 需要经常GROUP BY和ORDER BY的列
  4. UPDATE、DELETE的WHERE条件列,一般也需要创建索引
  5. DISTINCT字段需要创建索引
  6. 多表JOIN的连接字段需要创建索引
    • 连接表的数量尽量不要超过3张,因为每增加一张表就相当于增加了一次嵌套的循环,数量级增长会非常快,严重影响查询的效率。
    • 其次,对WHERE条件创建索引,因为WHERE才是对数据条件的过滤。如果在数据量非常大的情况下,没有WHERE条件过滤是非常可怕的。
    • 最后,对用于连接的字段创建索引,并且该字段在多张表中的类型必须一致。比如user_id在product_comment表和user表中都为int(11)类型,而不能一个为int另一个为varchar类型。

索引失效

  1. 索引进行了表达式计算

需要把索引字段的取值都取出来,然后依次进行表达式的计算来进行条件判断,因此采用的就是全表扫描的方式;

  1. 对索引使用函数
  2. 在WHERE子句中,如果在OR前的条件列进行了索引,而在OR后的条件列没有进行索引

OR的含义就是两个只要满足一个即可,因此只有一个条件列进行了索引是没有意义的,只要有条件列没有进行索引,就会进行全表扫描;

  1. 使用LIKE进行模糊查询的时候,前面不能是%
  2. 索引列尽量设置为NOT NULL约束

判断索引列是否为NOT NULL,往往需要走全表扫描,因此我们最好在设计数据表的时候就将字段设置为NOT NULL约束。

锁

锁的分类

按照锁粒度进行划分

我们从锁定对象的粒度大小来对锁进行划分,分别为行锁、页锁和表锁。

  1. 行锁

按照行的粒度对数据进行锁定。锁定力度小,发生锁冲突概率低,可以实现的并发度高,但是对于锁的开销比较大,加锁会比较慢,容易出现死锁情况。

  1. 页锁

是在页的粒度上进行锁定,锁定的数据资源比行锁要多,因为一个页中可以有多个行记录。当我们使用页锁的时候,会出现数据浪费的现象,但这样的浪费最多也就是一个页上的数据行。页锁的开销介于表锁和行锁之间,会出现死锁。锁定粒度介于表锁和行锁之间,并发度一般。

  1. 表锁

对数据表进行锁定,锁定粒度很大,同时发生锁冲突的概率也会较高,数据访问的并发度低。不过好处在于对锁的使用开销小,加锁会很快。

从数据库管理的角度对锁进行划分

我们还可以从数据库管理的角度对锁进行划分,分为共享锁和排它锁。

  1. 共享锁

也叫读锁或S锁,共享锁锁定的资源可以被其他用户读取,但不能修改。在进行SELECT的时候,会将对象进行共享锁锁定,当数据读取完毕之后,就会释放共享锁,这样就可以保证数据在读取时不被修改。

  1. 排它锁

也叫独占锁、写锁或X锁。排它锁锁定的数据只允许进行锁定操作的事务使用,其他事务无法对已锁定的数据进行查询或修改。

  1. 意向锁(Intent Lock)

简单来说就是给更大一级别的空间示意里面是否已经上过锁。举个例子,你可以给整个房子设置一个标识,告诉它里面有人,即使你只是获取了房子中某一个房间的锁。这样其他人如果想要获取整个房子的控制权,只需要看这个房子的标识即可,不需要再对房子中的每个房间进行查找。这样是不是很方便?

返回数据表的场景,如果我们给某一行数据加上了排它锁,数据库会自动给更大一级的空间,比如数据页或数据表加上意向锁,告诉其他人这个数据页或数据表已经有人上过排它锁了,这样当其他人想要获取数据表排它锁的时候,只需要了解是否有人已经获取了这个数据表的意向排他锁即可。

如果事务想要获得数据表中某些记录的共享锁,就需要在数据表上添加意向共享锁。同理,事务想要获得数据表中某些记录的排他锁,就需要在数据表上添加意向排他锁。这时,意向锁会告诉其他事务已经有人锁定了表中的某些记录,不能对整个表进行全表扫描。

从程序员的角度进行划分

如果从程序员的视角来看锁的话,可以将锁分成乐观锁和悲观锁。

  1. 乐观锁(Optimistic Locking)

认为对同一数据的并发操作不会总发生,属于小概率事件,不用每次都对数据上锁,也就是不采用数据库自身的锁机制,而是通过程序来实现。在程序上,我们可以采用版本号机制或者时间戳机制实现。

  1. 悲观锁(Pessimistic Locking)

也是一种思想,对数据被其他事务的修改持保守态度,会通过数据库自身的锁机制来实现,从而保证数据操作的排它性。

避免死锁的发生

  1. 如果事务涉及多个表,操作比较复杂,那么可以尽量一次锁定所有的资源,而不是逐步来获取,这样可以减少死锁发生的概率;
  2. 如果事务需要更新数据表中的大部分数据,数据表又比较大,这时可以采用锁升级的方式,比如将行级锁升级为表级锁,从而减少死锁产生的概率;
  3. 不同事务并发读写多张数据表,可以约定访问表的顺序,采用相同的顺序降低死锁发生的概率。

优化步骤

慢查询定位执行慢的SQL

1
mysql > show variables like '%slow_query_log';

开启慢查询日志

1
mysql > set global slow_query_log='ON';

EXPLAIN查看执行计划

EXPLAIN可以帮助我们了解数据表的读取顺序、SELECT子句的类型、数据表的访问类型、可使用的索引、实际使用的索引、使用的索引长度、上一个表的连接匹配条件、被优化器查询的行的数量以及额外的信息(比如是否使用了外部排序,是否使用了临时表等)等。

EXPLAIN会返回一个表格:其中type是关键信息。

all是最坏的情况,因为采用了全表扫描的方式。index和all差不多,只不过index对索引表进行全扫描,这样做的好处是不再需要对数据进行排序,但是开销依然很大。如果我们在Extral列中看到Using index,说明采用了索引覆盖,也就是索引可以覆盖所需的SELECT字段,就不需要进行回表,这样就减少了数据查找的开销。

SHOW PROFILE查看SQL的具体执行成本

看下当前会话都有哪些profiles:

1
mysql > show profiles;

想要查看上一个查询的开销,可以使用:

1
mysql > show profile;

缓冲池和查询缓存的区别

对比

对比维度 缓冲池(Buffer Pool) 查询缓存(Query Cache)
适用场景 几乎所有场景,是数据库高性能的绝对核心。 极少更新、大量完全相同读取的静态表(如配置表、字典表)。
缓存内容 数据页和索引页(通常每页 16KB),即底层的物理/逻辑数据块。 完整的 SQL 查询语句及其对应的完整结果集。
工作原理 InnoDB 在内存中开辟的一块连续空间。当你执行查询时,InnoDB 会先检查需要的数据页是否在 Buffer Pool 中。如果在(缓存命中),直接返回内存数据;如果不在(缓存未命中),则从磁盘读取该页到 Buffer Pool 中,然后再返回数据。 在 Server 层维护一个哈希表,Key 是 SQL 语句的哈希值,Value 是查询结果集。收到 SELECT 请求时,先计算哈希值去查表,命中则直接返回,跳过解析、优化、执行和存储引擎交互的所有步骤。
写入机制 当执行更新操作时,InnoDB 会先修改 Buffer Pool 中的数据页,并将其标记为”脏页(Dirty Page)”,随后由后台线程异步将这些脏页刷入磁盘(Flush)。这保证了写入的高性能。 -

查询缓存被淘汰

MySQL 官方在 8.0 版本中彻底移除了 Query Cache,主要原因包括:

  1. 扩展性差:查询缓存的全局锁机制在多核 CPU 和高并发环境下成为严重的性能瓶颈。
  2. 失效过于频繁:现代互联网应用读写频繁,查询缓存命中率极低,大部分时间都在做”缓存-失效”的无用功。
  3. 更优的替代方案:应用层缓存(如 Redis 或 Memcached)提供了更细粒度、更灵活、更高性能的缓存控制能力,完全取代了数据库层做结果集缓存的需求。

总结

进阶篇主要围绕数据库性能优化展开,涵盖了从宏观的调优方向到微观的索引实现细节。核心要点包括:

  1. 调优要多维度考虑:选择合适的DBMS、优化表设计、改进查询逻辑,而不是只盯着SQL语句本身
  2. 范式不是越高越好:需要在规范性和性能之间找到平衡,该反范式时就反范式
  3. 索引是把双刃剑:能加速查询但会增加写入成本和存储开销,要根据实际场景判断是否创建
  4. 理解底层原理:B+树、哈希索引、锁机制等原理能帮助我们更好地理解性能问题的根源
  5. 工具辅助诊断:慢查询日志、EXPLAIN、SHOW PROFILE等工具是定位性能瓶颈的利器

数据库优化是一个系统工程,需要结合业务特点、数据规模、硬件资源等多方面因素综合考虑。没有一招鲜吃遍天的银弹,只有不断实践、测试、验证,才能找到最适合自己项目的优化方案。

下一步可以继续深入学习事务、MVCC、分库分表等更高级的话题,也欢迎查看本系列的其他文章:

前言

在学习阶段,我一般不会刻意注意代码规范或潜在漏洞。毕竟代码不正式上线,也没有人专门做审查,很多问题只要“能跑”就被我放过去了。

但现在既然开始做正式项目,就不能再只看功能是否实现。代码能运行只是第一步,后面还要考虑:它是否容易维护、有没有明显缺陷、提交后会不会破坏原有功能,以及团队成员能不能快速看懂。

最近我了解并试用了几种代码质量工具,这里分享给大家。

先说结论:不同工具解决不同问题

工具 主要作用 适用
SpotBugs 发现 Java 字节码中的潜在 Bug IDEA、本地构建、CI
Checkstyle 检查命名、缩进、导入顺序等代码规范 IDEA、本地构建、CI
CodeRabbit 对 Pull Request 做 AI 辅助审查 GitHub PR
reviewdog 把各种检查结果统一评论到代码变更上 GitHub Actions 等 CI

这四个工具的作用领域不同:

  • SpotBugs 更关心“代码可能有问题”;
  • Checkstyle 更关心“代码是否符合团队规范”;
  • CodeRabbit 更接近自动化的代码审查助手;
  • reviewdog 本身通常不负责分析代码,而是负责收集其他工具的输出,并把问题准确标到 PR 对应行上。

SpotBugs:发现潜在 Bug

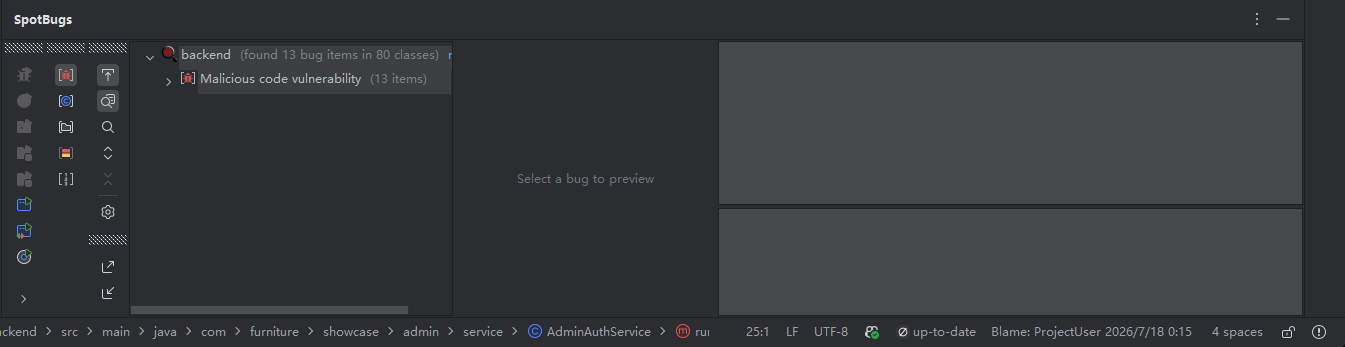
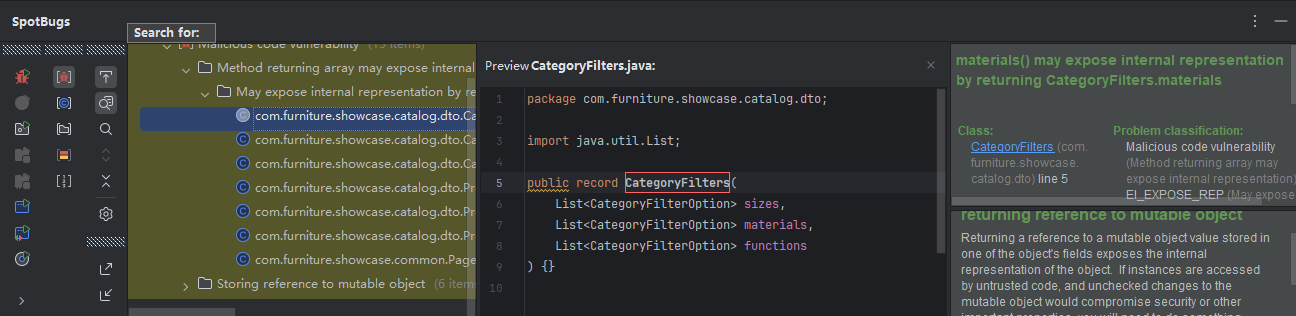
SpotBugs 是 FindBugs 的后继项目。它会分析 Java 编译后的字节码,寻找空指针、错误的对象比较、资源未关闭、可变对象暴露等潜在问题。

它既有 IDEA 插件,也支持 Maven、Gradle 和 CI。对我来说,IDEA 插件适合在本地快速查看,Maven 插件更适合放进项目流程,避免出现“我的电脑装了插件,但其他人没有装”的情况。

运行完成后,下方会按类型展示检查结果:

选择具体问题后,可以查看对应代码、问题分类和解释:

{spotbugs-detail.png}

spotbugs-detail.png

Maven 配置

下面给出一个比较基础的配置。插件版本建议统一放在项目的 properties 或父 POM 中管理,不要每个模块各写一份。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
<plugin>
<groupId>com.github.spotbugs</groupId>
<artifactId>spotbugs-maven-plugin</artifactId>
<configuration>
<effort>Max</effort>
<threshold>Medium</threshold>
</configuration>
<executions>
<execution>
<goals>
<goal>check</goal>
</goals>
</execution>
</executions>
</plugin>

执行命令:

1
mvn spotbugs:check

需要注意的是,SpotBugs 报告的是“可疑模式”,不代表每一条都一定是 Bug。正确的处理方式是先理解提示,再决定修改、抑制还是调整规则,而不是看到警告就机械改代码。

Checkstyle:统一代码规范

Checkstyle 主要检查代码风格,例如命名、格式、缩进、导入顺序、代码块写法等。

它不会判断业务逻辑是否正确,但可以减少大量没有意义的格式争论。特别是在多人协作时,最好把规范写成配置文件并提交到仓库,而不是只依赖每个人 IDE 里的个人设置。

IDEA 中使用

安装 Checkstyle 插件后,可以进入:

1
2
3
Settings
-> Tools
-> Checkstyle

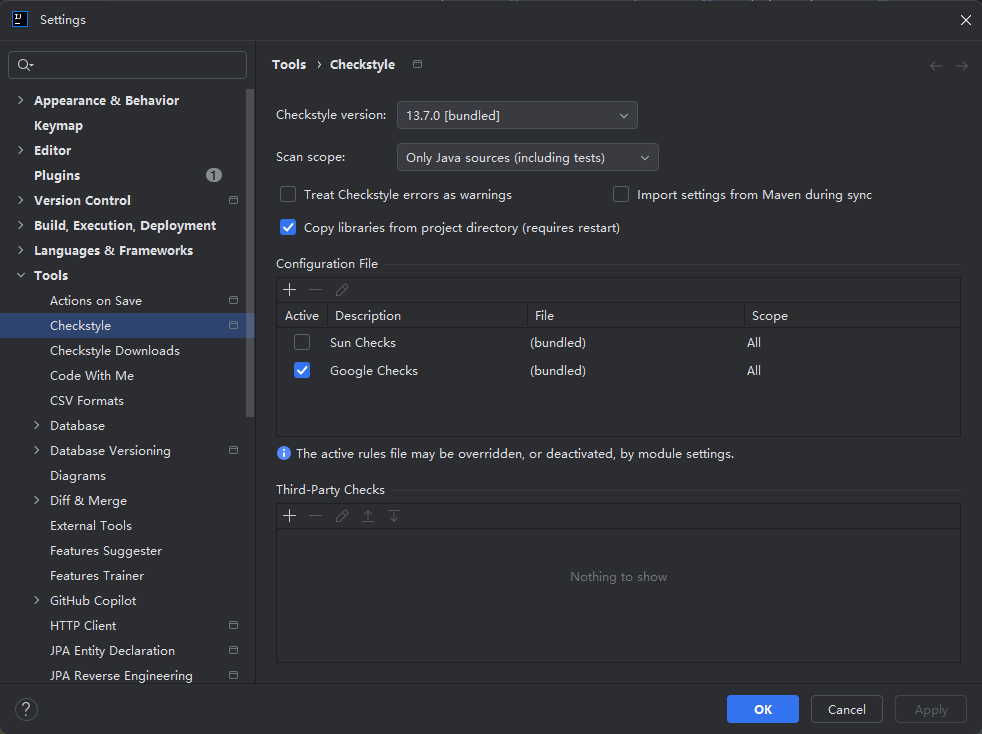
我这里选择了内置的 Google Checks。点击 Apply 后,可以对单个 Java 文件、目录或整个项目执行检查。

例如下面这段结果,就是在提示等号和花括号附近缺少空格:

1
2
3
4
5
6
Running style checker on 1 file(s) (config: fa26)...
ProductAdminUpdate.java:8:20: '=' 前应有空格。
ProductAdminUpdate.java:8:20: '=' 后应有空格。
ProductAdminUpdate.java:10:3: '{' 后应有空格。
ProductAdminUpdate.java:10:4: '}' 前应有空格。
Style checker completed with 4 errors.

Maven 配置

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
<plugin>
<groupId>org.apache.maven.plugins</groupId>
<artifactId>maven-checkstyle-plugin</artifactId>
<configuration>
<configLocation>checkstyle.xml</configLocation>
<consoleOutput>true</consoleOutput>
<failsOnError>true</failsOnError>
</configuration>
<executions>
<execution>
<phase>verify</phase>
<goals>
<goal>check</goal>
</goals>
</execution>
</executions>
</plugin>

执行命令:

1
mvn checkstyle:check

如果团队准备长期使用,建议从现有代码能够接受的规则开始,再逐步收紧。直接套一份特别严格的规则,往往会一下出现几千条历史问题,最后大家只能选择关闭检查。

CodeRabbit:辅助审查 Pull Request

CodeRabbit 的定位和前两个工具不太一样。它主要接入 GitHub 等代码托管平台,在 Pull Request 创建或更新后分析变更,并给出摘要、逐行建议和潜在问题。

我认为它比较适合发现下面这些问题:

  • 修改范围较大,人工审查容易漏看;
  • 代码能够编译,但边界条件没有处理;
  • 方法命名、异常处理或重复逻辑不够合理;
  • PR 描述不完整,需要先快速了解本次改动。

不过 AI 审查只能作为辅助,不能代替开发者负责。它不了解全部业务背景,也可能给出看似合理但并不适合当前项目的建议。最终是否修改,仍然要结合需求、测试和上下文判断。

reviewdog:把检查结果送到 PR

reviewdog 是我在 GitHub 的 Code Quality 分类中较早发现的项目。

我一开始以为它也是一个代码检查器,后来才发现它更像一个“结果转发器”:Checkstyle、静态分析器或 Linter 负责发现问题,reviewdog 负责读取这些工具的输出,再把问题作为 PR 评论或检查结果展示出来。

例如可以在 CI 中执行 Checkstyle,再把结果交给 reviewdog。这样开发者不必翻完整日志,就能直接在改动行附近看到提示。

它的价值主要有两点:

  1. 统一不同检查工具的展示方式;
  2. 只关注本次代码变更,避免历史问题淹没新的问题。

我目前推荐的组合

如果是一个普通 Java 项目,我会按下面的顺序接入:

  1. IDE 阶段:使用 Checkstyle 和 SpotBugs 插件,尽量在提交前解决问题;
  2. Maven 阶段:把规则写入 pom.xml,保证任何人执行构建都使用同一套标准;
  3. CI 阶段:运行测试、Checkstyle 和 SpotBugs,不通过就阻止合并;
  4. PR 阶段:根据项目情况接入 CodeRabbit,或用 reviewdog 展示已有工具的结果;
  5. 人工审查:检查业务逻辑、架构影响和需求是否真正实现。

工具链不宜一次堆得太满。先解决项目当前最明显的问题,再逐步增加规则,比安装一堆工具却没有人看结果更有效。

前言

专栏在完结多年后又增加了几篇加餐,主要分成两类内容:

  • Text to SQL:使用自然语言生成 SQL;
  • 行业实战:银行、保险、证券、新能源车企和快消场景中的查询与优化。

行业实战部分已经写得很具体,我就不重复搬运原文了。这篇主要整理 Text to SQL 的思路,并补充一些我认为真正落地时必须注意的问题。

Text to SQL 是什么

Text to SQL,简单来说就是把自然语言问题转换成 SQL 查询。

例如用户提出:

查询最近 30 天销量最高的 10 个商品,并显示商品名称和销售额。

模型需要先理解“最近 30 天”“销量最高”“销售额”等业务含义,再结合数据表、字段、关联关系和数据库类型,生成可以执行的 SQL。

它降低了 SQL 的使用门槛,但不意味着完全不需要懂 SQL。特别是涉及复杂查询、权限控制、性能优化和数据修改时,最终仍然需要有人检查生成结果。

不要只看模型榜单

原内容列举了当时常见的闭源模型、开源模型和代码模型。但模型版本更新很快,半年后榜单可能就已经没有参考价值了,所以这里不再按名称排一个容易过时的名次。

如果要选择 Text to SQL 模型,我更关心下面几点:

  1. Schema 理解能力:能否理解表结构、主外键、字段注释和业务含义;
  2. 复杂查询能力:能否正确生成多表连接、聚合、窗口函数和子查询;
  3. 方言支持:是否知道 MySQL、PostgreSQL、SQL Server 等数据库的语法差异;
  4. 结构化输出能力:能否稳定地只返回 SQL 或指定 JSON,而不是夹杂大段说明;
  5. 上下文长度与成本:面对大量表结构时,能否在成本可接受的情况下完成任务;
  6. 本地部署需求:敏感数据是否允许发送到外部服务。

对实际项目来说,用自己的数据库问题做一套测试集,通常比只看公开榜单更可靠。

Text to SQL 的完整流程

如果只是把一句自然语言和整个数据库结构一起丢给模型,简单问题可能能用,但表一多,准确率就会明显下降。

我目前理解的完整流程如下:

  1. 理解用户问题:识别指标、维度、筛选条件、时间范围和排序要求;
  2. 检索相关 Schema:只找与当前问题有关的表和字段,而不是把整个数据库全部塞进去;
  3. 补充业务语义:说明“有效订单”“销售额”“新增用户”等业务概念如何计算;
  4. 生成 SQL:明确数据库方言,并限制输出格式;
  5. 静态校验:检查表名、字段名、语法、危险语句和权限范围;
  6. 试执行或解释执行计划:优先使用只读账号,必要时先执行 EXPLAIN;
  7. 根据错误修正:把数据库返回的错误信息交给模型进行有限次数的修复;
  8. 返回结果与说明:除了查询结果,还应说明口径和可能存在的限制。

这套流程中,真正困难的往往不是“写出一条看起来像 SQL 的字符串”,而是找到正确的表、理解业务口径,并保证执行安全。

提示词应该提供什么

原文给出了三种提示词。核心结论是:与一段模糊的中文表说明相比,结构化的建表语句通常能给模型更多信息。

我认为一个比较实用的提示至少应包含:

  • 数据库类型和版本;
  • 相关表的 DDL;
  • 字段注释和枚举含义;
  • 表之间的关联关系;
  • 用户问题;
  • 输出格式;
  • 安全限制;
  • 必要时提供一两个相似示例。

可以写成下面这样:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
你是一名 SQL 助手,请根据给定的数据库结构生成查询。

数据库方言:MySQL 8.0

要求:
1. 只生成 SELECT 或 WITH 查询;
2. 不允许生成 INSERT、UPDATE、DELETE、DROP、ALTER、TRUNCATE;
3. 只使用提供的表和字段;
4. 无法确定业务口径时先提出问题,不要自行猜测;
5. 最终只在一个 sql 代码块中返回 SQL。

用户问题:
{query}

数据库结构:
```sql
{create_sql}
```

业务说明:
{business_context}

这里的 create_sql 不只是表名列表,最好包含字段类型、主键、外键、唯一约束和注释。因为这些信息能帮助模型判断字段用途,也能减少编造不存在字段的情况。

为什么“只给 DDL”仍然不够

DDL 适合描述数据库结构,但它不一定能表达业务语义。

例如订单表中可能同时存在:

  • created_at:订单创建时间;
  • paid_at:支付时间;
  • finished_at:完成时间;
  • cancelled_at:取消时间。

用户问“本月订单量”时,到底应该使用哪个时间字段?只看 DDL 很难确定。因此在真实项目中,还需要补充指标定义、字段说明,或者让模型在不确定时先追问。

另一个问题是表太多。假设数据库中有几百张表,把所有 DDL 都放进提示词不仅浪费上下文,还会增加模型选错表的概率。更合理的方式是先检索相关表,再生成 SQL,也就是把问题拆成“找表”和“写 SQL”两个阶段。

安全问题比生成能力更重要

Text to SQL 最危险的地方,不是 SQL 写错后报语法错误,而是它能够执行,但查询口径错误、扫描数据过多,甚至修改了不该修改的数据。

我认为至少要做下面几层限制:

使用只读账号

面向查询的 Text to SQL 服务不应该连接拥有写权限或 DDL 权限的数据库账号。即使提示词要求“只生成 SELECT”,也不能把安全完全寄托在模型听话上。

限制语句类型

在执行前解析 SQL,只允许 SELECT、WITH 和必要的解释语句。不能只用简单的字符串包含判断,因为注释、大小写和嵌套语法都可能绕过这种检查。

控制查询成本

可以设置超时时间、最大返回行数和资源限制。对可能扫描大量数据的语句,先使用 EXPLAIN 检查执行计划。

记录审计日志

保留用户问题、模型生成的 SQL、执行结果、耗时和错误信息。后续出现问题时,至少能够知道是哪一步出了错。

如何评估生成质量

只看 SQL 能不能执行是不够的。一条 SQL 即使语法正确,也可能回答了另一个问题。

可以从下面几个角度评估:

维度 需要检查的问题
可执行性 SQL 是否能够在目标数据库中执行
结果正确性 返回结果是否符合预期口径
Schema 一致性 是否使用了真实存在的表和字段
安全性 是否包含越权查询或危险操作
性能 是否出现不必要的全表扫描、笛卡尔积或重复子查询
稳定性 同类问题换一种说法后,结果是否仍然正确

如果准备把 Text to SQL 用到正式项目,最好先收集一批真实问题和标准 SQL,做成固定测试集。每次更换模型、提示词或 Schema 检索方式后都重新跑一遍,才能知道效果到底变好了还是变差了。

加餐 02~06:行业查询与优化

这部分主要是原作者从真实开发场景中提炼的经验,针对性很强。我想了一下,原文已经整理得比较精简,我就不班门弄斧了,直接把对应链接列出来,请有需要的朋友自行查看。

前言

在这里推荐一下 my-geektime,里面收录了不少开发类学习资料,我一般把它当作在线阅读索引使用。

《SQL 必知必会》专栏地址

作者将课程分成了四个模块:

  • 基础篇:以 NBA 球队、球员数据和游戏数据为案例,讲解 SQL 基础语法;
  • 进阶篇:从执行效率出发,分析常见的 SQL 性能问题;
  • 高级篇:介绍不同关系型数据库管理系统中的 SQL 使用场景;
  • 实战篇:把前面的内容用于数据清洗、数据集成和分析项目。

这篇文章按照作者的思路整理基础篇,但我会重新调整顺序,省略一部分太基础的语法,并补上我自己查资料后对原笔记的修正。如有漏误,欢迎指正。

SQL 基本概念

SQL 语言的常见分类

学习资料中通常会把 SQL 按功能分成下面几类:

分类 英文 主要用途 常见语句
DDL Data Definition Language 定义数据库对象 CREATE、ALTER、DROP
DML Data Manipulation Language 新增、修改和删除数据 INSERT、UPDATE、DELETE
DQL Data Query Language 查询数据 SELECT
DCL Data Control Language 权限与安全控制 GRANT、REVOKE
TCL Transaction Control Language 控制事务 COMMIT、ROLLBACK、SAVEPOINT

不同资料的分类方式可能略有差异,例如有些资料会把 SELECT 也归入广义的 DML。这类分类主要是为了学习方便,不必太纠结边界。

大小写与命名风格

SQL 关键字通常不区分大小写,但为了可读性,我习惯:

  • 表名、表别名、字段名和字段别名使用小写;
  • SQL 关键字和内置函数使用大写;
  • 字符串使用单引号包裹。
1
2
3
SELECT name, hp_max
FROM heros
WHERE role_main = '战士';

这是一种代码风格,不是所有数据库都强制要求。标识符是否区分大小写,还会受到数据库类型、操作系统和是否使用引号等因素影响,所以团队最好统一规范。

关系型数据库与 NoSQL

关系型数据库建立在关系模型之上,使用表、行、列和约束来组织数据,常见产品包括 MySQL、PostgreSQL、Oracle 和 SQL Server。

NoSQL 一般指非关系型数据库,常见类型包括:

  • 键值数据库;
  • 文档数据库;
  • 列族数据库;
  • 图数据库;
  • 搜索与分析引擎。

它们不是简单的“先进”和“落后”关系。关系型数据库擅长事务、约束和复杂查询,NoSQL 往往针对特定访问模式、扩展方式或数据结构进行优化。实际选型还是要看业务需求。

MySQL 中一条 SQL 如何执行

MySQL 采用客户端/服务器架构。客户端建立连接并发送 SQL,服务器完成解析、优化和执行,存储引擎负责真正读取或写入数据。

为了便于理解,可以把一次查询粗略分成下面几步:

  1. 连接与权限上下文:建立连接、认证用户,并准备会话环境;
  2. 解析与语义检查:检查语法,识别表、字段和表达式;
  3. 查询优化:选择表连接顺序、访问方式和可用索引;
  4. 执行:执行器调用存储引擎接口读取数据;
  5. 返回结果:将结果集发送给客户端。

需要修正原笔记中的一点:MySQL 5.7 还保留查询缓存,但默认关闭;MySQL 8.0 已经移除了查询缓存。因此在 MySQL 8.0 的执行流程中,不应该再把“查询缓存”作为固定步骤。

优化器给出的执行计划不一定永远最优,因为它依赖统计信息和成本估算。遇到慢查询时,应该使用 EXPLAIN 或 EXPLAIN ANALYZE 检查实际访问方式,而不是只凭 SQL 表面判断。

SELECT 的书写顺序与逻辑顺序

书写顺序

常见查询的书写顺序如下:

1
2
3
4
5
6
7
8
SELECT ...
FROM ...
JOIN ... ON ...
WHERE ...
GROUP BY ...
HAVING ...
ORDER BY ...
LIMIT ...;

逻辑处理顺序

从理解查询的角度,可以近似记成:

1
2
3
4
5
6
7
8
FROM / JOIN
-> WHERE
-> GROUP BY
-> HAVING
-> SELECT
-> DISTINCT
-> ORDER BY
-> LIMIT

这个顺序主要帮助我们理解为什么:

  • WHERE 中通常不能直接使用当前层 SELECT 定义的别名;
  • HAVING 可以过滤聚合后的分组;
  • ORDER BY 通常可以使用 SELECT 中的别名。

它不是 MySQL 源码中每一步的机械执行顺序。优化器可能重写查询,只要最终语义保持一致。

常见查询细节

为什么生产代码不推荐随手写 SELECT *

SELECT * 在临时查看数据时很方便,但在正式查询中有几个问题:

  • 读取不需要的列,增加网络传输和对象映射开销;
  • 表结构新增字段后,接口返回可能悄悄发生变化;
  • 无法直接看出查询真正依赖哪些字段;
  • 在部分场景下不利于使用覆盖索引。

因此业务代码中最好明确列名:

1
2
3
SELECT id, name, hp_max
FROM heros
WHERE role_main = '战士';

常见函数分类

内置函数可以粗略分为:

  • 数值函数;
  • 字符串函数;
  • 日期与时间函数;
  • 类型转换函数;
  • 聚合函数;
  • 窗口函数。

不同数据库的函数名和行为可能不同,特别是日期处理、字符串拼接和类型转换,迁移数据库时要重点检查。

WHERE 与 HAVING 的区别

WHERE 在分组和聚合之前过滤数据行,HAVING 在分组之后过滤分组结果。

1
2
3
4
5
SELECT role_main, COUNT(*) AS hero_count
FROM heros
WHERE hp_max > 5000
GROUP BY role_main
HAVING COUNT(*) >= 3;

能放进 WHERE 的普通条件通常应该尽量提前过滤,以减少后续需要参与分组的数据量。

IN 与 EXISTS 怎么选

常见写法如下:

1
2
3
SELECT *
FROM a
WHERE a.cc IN (SELECT b.cc FROM b);
1
2
3
4
5
6
7
SELECT *
FROM a
WHERE EXISTS (
SELECT 1
FROM b
WHERE b.cc = a.cc
);

原笔记使用“外表大就用 IN,外表小就用 EXISTS”来判断,这个经验过于绝对。现代优化器可能把两种写法改写成相近的半连接计划,实际性能还取决于索引、数据分布、空值、选择性和数据库版本。

更稳妥的做法是:

  1. 先保证写法表达正确语义;
  2. 给关联列建立合适索引;
  3. 使用 EXPLAIN ANALYZE 对真实数据进行比较。

另外,NOT IN 遇到 NULL 时容易产生不符合直觉的结果。需要排除不存在的数据时,我通常更倾向于明确处理空值,或使用 NOT EXISTS。

视图

视图可以理解为保存下来的查询。普通视图通常不单独保存查询结果,而是在使用时基于底层表执行对应 SQL。

它的常见作用包括:

  1. 简化查询:把复杂连接和计算封装起来;
  2. 复用逻辑:让多个调用方使用同一套查询定义;
  3. 控制暴露字段:只向特定用户开放允许访问的列;
  4. 兼容接口:底层表变化时,通过视图保持上层查询相对稳定。

视图是否可更新取决于数据库和视图定义。包含聚合、分组、DISTINCT、集合运算或复杂连接的视图通常不能直接更新,不能简单认为“所有视图都只读”或“所有单表视图都可写”。

存储过程

存储过程是保存在数据库服务器中的一组 SQL 和流程控制语句。创建后可以像调用函数一样执行。

下面用 MySQL 存储过程计算从 1 到 n 的累加值:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
DELIMITER //

CREATE PROCEDURE add_num(IN n INT)
BEGIN
DECLARE i INT DEFAULT 1;
DECLARE total INT DEFAULT 0;

WHILE i <= n DO
SET total = total + i;
SET i = i + 1;
END WHILE;

SELECT total;
END //

DELIMITER ;

MySQL 存储过程常见参数类型:

参数类型 作用
IN 向存储过程传入参数
OUT 把存储过程中的结果返回给调用方
INOUT 同时作为输入和输出参数

存储过程的优点是靠近数据、便于封装固定数据库逻辑;缺点是数据库方言差异大、调试和版本管理不如应用代码方便,也容易把业务逻辑过度集中到数据库中。

因此它并不是“高并发一定不能用”,而是需要结合团队维护能力、数据库压力、部署方式和扩展需求判断。

游标

SQL 更擅长面向集合处理,游标则允许逐行读取查询结果。它适合确实需要逐条处理的场景,但如果能用一条集合 SQL 完成,通常不要优先写游标。

下面是 MySQL 存储过程中的一个示例,用游标累计所有英雄的最大生命值:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
DELIMITER //

CREATE PROCEDURE calc_hp_sum()
BEGIN
DECLARE done BOOLEAN DEFAULT FALSE;
DECLARE hp INT;
DECLARE hp_sum BIGINT DEFAULT 0;

DECLARE cur_hero CURSOR FOR
SELECT hp_max FROM heros;

DECLARE CONTINUE HANDLER FOR NOT FOUND
SET done = TRUE;

OPEN cur_hero;

read_loop: LOOP
FETCH cur_hero INTO hp;

IF done THEN
LEAVE read_loop;
END IF;

SET hp_sum = hp_sum + hp;
END LOOP;

CLOSE cur_hero;
SELECT hp_sum;
END //

DELIMITER ;

原笔记中写了 DEALLOCATE cursor_name,这不是 MySQL 存储过程游标的语法。MySQL 游标使用 DECLARE、OPEN、FETCH 和 CLOSE,并且只能在存储程序中声明。

数据库设计:原则不是越少越好

原文提到了“三少一多”,但如果直接记成“表越少越好、字段越少越好、外键越多越好”,很容易走向另一个极端。

我现在更愿意把数据库设计理解成下面几条平衡原则。

一个表尽量表达一个清晰主题

表不是越少越好。把用户、订单、商品全部塞进一张大表,虽然表少了,但会产生大量重复数据和更新异常。

合理拆表的目标是让实体和关系清晰,同时避免为了“看起来规范”而拆出大量没有实际价值的小表。

字段需要保持原子性和明确含义

字段也不是越少越好。应该避免把多个含义塞进一个字符串字段,也要谨慎保存能够稳定计算出的重复数据。

但在读取压力大、计算成本高的场景中,适度冗余又可能是合理优化。关键是明确一致性如何维护。

主键要稳定,联合主键不要滥用

主键应当唯一、非空并尽量稳定。联合主键不是错误,但字段过多会让外键引用、索引和应用代码变复杂。

外键约束要结合架构选择

外键能保证引用完整性,但也会增加写入和迁移时的约束。在单体系统或数据一致性要求高的系统中,外键很有价值;在分库分表或跨服务场景中,关系可能需要由应用和审计机制维护。

多表连接:优先使用显式 JOIN

旧式写法常把多张表放在 FROM 中,再在 WHERE 中写连接条件:

1
2
3
SELECT h.name, r.role_name
FROM heros h, roles r
WHERE h.role_id = r.id;

现在更推荐显式 JOIN ... ON ...:

1
2
3
SELECT h.name, r.role_name
FROM heros AS h
JOIN roles AS r ON r.id = h.role_id;

显式 JOIN 能把连接条件和过滤条件分开,层次更清晰,也能减少漏写连接条件导致笛卡尔积的风险。

NATURAL JOIN 和 USING 虽然更短,但会依赖同名列。表结构变化后可能悄悄改变连接行为,所以在业务 SQL 中我更倾向于明确写出 ON 条件。

MySQL 5.7 与 8.0 的几个重要区别

MySQL 8.0 相比 5.7 的变化很多,这里只记我认为最常见的部分:

方面 MySQL 5.7 MySQL 8.0
查询缓存 保留,但默认关闭 已移除
默认字符集 latin1 utf8mb4
窗口函数 不支持 支持
公用表表达式 CTE 不支持 支持 WITH,包括递归 CTE
数据字典 主要依赖文件和系统表 使用事务型数据字典
默认认证插件 mysql_native_password 早期 8.0 默认使用 caching_sha2_password

从 5.7 升级到 8.0 时,除了语法和功能,还要检查字符集、排序规则、保留字、认证方式和已废弃配置,不能只看 SQL 能不能执行。

COUNT(*)、COUNT(1) 与 COUNT(字段)

这三个写法最重要的区别不是谁更快,而是语义。

  • COUNT(*):统计结果集中的行数;
  • COUNT(1):表达式 1 对每一行都不为 NULL,通常也统计行数;
  • COUNT(column):只统计该字段不为 NULL 的行数。

在 MySQL InnoDB 中,COUNT(*) 和 COUNT(1) 通常会得到相同的执行计划,没有必要为了所谓的性能差异把所有代码改成 COUNT(1)。

对于没有 WHERE 和 GROUP BY 的精确行数统计,InnoDB 不能像 MyISAM 那样直接返回一个始终准确的固定行数,因为它需要考虑事务和 MVCC。优化器会选择合适的索引进行扫描,通常倾向于较小的可用二级索引;没有二级索引时才扫描聚簇索引。

这里要避免另一个误区:不要只为了 COUNT(*) 就盲目创建一个没有业务价值的二级索引。索引会占空间,也会增加写入成本。是否建立索引,应该结合整个查询和写入负载判断。

我的结论是:

  1. 统计行数时优先写语义清楚的 COUNT(*);
  2. 统计某字段非空数量时使用 COUNT(column);
  3. 真正遇到性能问题时,用执行计划和真实数据验证,不要只背固定结论。

前言

今天也是有幸第一次约到了面试,下面进行分享。

这篇文章主要分为三部分:自我介绍的组织方式、面试中被问到的问题、面试后的复盘感悟。其中问题部分我按照主题重新整理了一下,并补上了面试后复盘出的参考回答。

自我介绍

要求 3 分钟自我介绍,我大致按照下面的顺序讲了一轮:

  1. 目标岗位
  2. 奖项经历
  3. 技术栈
  4. 项目经历
  5. 开源经历
  6. 简短总结

整体还是有点考验记忆的,不过这些内容都是自己做过的,所幸也没有卡词。等自我介绍结束后,我也差不多适应了面试氛围,刚好进入问答环节。

提问

顺序可能不太一样,我将同类型的问题放在一块了,实际面试时是混着来的。一共有三个面试官,第一位主要问缓存相关的问题,第二位主要问事务相关问题以及一些实际生产问题,第三位则是问一些 Java 基础相关的问题。

网络基础

HTTP 和 HTTPS 的区别

这一问直接炸了。因为我们大三才学计网,虽然自己在上学期自学过一点,但到现在早已经没印象了,只知道 HTTPS 的安全性高一些,索性直接爆了。

HTTP 是明文传输协议,默认端口是 80;HTTPS 可以理解为 HTTP + TLS/SSL,默认端口是 443。

主要区别有几点:

  • 安全性不同:HTTP 明文传输,容易被窃听、篡改;HTTPS 通过 TLS 加密传输。
  • 身份认证不同:HTTPS 依赖 CA 证书,可以验证服务端身份,降低中间人攻击风险。
  • 完整性保护不同:HTTPS 可以校验数据是否被篡改。
  • 性能成本不同:HTTPS 需要额外的握手和加解密过程,但现在硬件和协议优化后,这个成本通常可以接受。

如果面试时继续追问 HTTPS 的过程,可以从“客户端发起请求、服务端返回证书、客户端校验证书、协商会话密钥、后续使用对称加密通信”这个流程展开。

缓存与 Redis

什么是缓存穿透、缓存击穿和缓存雪崩?

这三个问题都和缓存失效有关,但原因不一样。

问题 典型场景 核心原因 常见解决方案
缓存穿透 查询一个根本不存在的数据 缓存和数据库都没有该数据,请求直接打到数据库 缓存空值、布隆过滤器、参数校验
缓存击穿 某个热点 key 突然过期 大量请求同时访问同一个失效热点 key 互斥锁、逻辑过期、热点 key 永不过期
缓存雪崩 大量 key 同时过期 大面积缓存同时失效,请求集中打到数据库 过期时间加随机值、缓存预热、多级缓存、限流降级

简单记忆就是:穿透是查不存在,击穿是热点 key 失效,雪崩是大量 key 一起失效。

商城中大量伪造商品 ID、热门商品突然失效、大量商品突然失效分别是什么问题?

这道题其实是把上面的概念放到业务场景里问。

  1. 大量伪造商品 ID 被发送到服务器:属于缓存穿透。因为这些商品 ID 可能根本不存在,缓存查不到,数据库也查不到。

    • 可以在入口做参数校验。
    • 可以用布隆过滤器提前判断商品 ID 是否可能存在。
    • 对不存在的数据缓存空值,并设置较短过期时间。
  2. 热门商品突然失效:属于缓存击穿。热门商品访问量很大,一旦缓存失效,请求会瞬间打到数据库。

    • 可以给热点商品设置逻辑过期。
    • 可以用互斥锁保证只有一个线程回源重建缓存。
    • 对极热数据可以考虑不过期,而是后台异步刷新。
  3. 大量商品突然失效:属于缓存雪崩。大量 key 同一时间失效,数据库压力会瞬间升高。

    • 给缓存过期时间加随机值,避免同一时间集中过期。
    • 做缓存预热。
    • 增加限流、降级和熔断保护。
    • Redis 高可用部署,避免单点故障。

商品详情这种数据如何构建缓存?

商品详情页通常读多写少,很适合缓存,但也要考虑一致性问题。

一种比较常见的方式是 Cache-Aside 思想。刚好我在项目中写到过类似逻辑,所以面试时就直接拉过来说,顺便往项目经历上展开了一下:

  1. 用户请求商品详情。
  2. 先查 Redis。
  3. Redis 命中则直接返回。
  4. Redis 未命中则查数据库。
  5. 数据库查到后写入 Redis,并设置过期时间。
  6. 如果商品被修改,先更新数据库,再删除缓存。

这里更推荐“更新数据库后删除缓存”,而不是直接更新缓存。因为商品详情可能由多个表拼装而来,直接更新缓存容易漏字段或写入脏数据。删除缓存后,下次查询再重新构建,逻辑会更简单。

需要注意的点:

  • 缓存 key 要设计清楚,比如 product:detail:{id}。
  • 过期时间不要完全相同,可以加随机值。
  • 热点商品可以做预热或逻辑过期。
  • 对不存在的商品可以缓存空值,防止穿透。
  • 修改商品信息时要保证数据库和缓存的最终一致性。

秒杀系统

如果让你设计一个商城秒杀系统,你会怎么做?从数据库设计层面讲一下。

秒杀系统的核心问题是:高并发下不能超卖,系统不能被瞬间打崩。

但当时还是比较有压力,没能仔细思考,只说了一下可以用加锁、事务、分布式缓存、多服务器并发来在一定程度上缓解这个问题。

从数据库设计角度,可以拆成几张核心表:

表 作用
product 普通商品信息
seckill_activity 秒杀活动信息,如开始时间、结束时间、状态
seckill_product 秒杀商品信息,如商品 ID、秒杀价、秒杀库存
seckill_order 秒杀订单,记录用户、商品、活动、订单状态

关键约束:

  • seckill_order 中可以对 (user_id, activity_id, product_id) 建唯一索引,防止同一用户重复抢购。
  • 库存扣减要用原子条件更新,例如:
1
2
3
UPDATE seckill_product
SET stock = stock - 1
WHERE id = #{id} AND stock > 0;

如果影响行数为 1,说明扣减成功;如果为 0,说明库存不足。

实际系统里不会让所有请求都直接打数据库。一般会把库存提前加载到 Redis,用 Redis 先做预扣减,再通过消息队列异步创建订单,数据库作为最终落库。

从事前、事中、事后的层面讲一下秒杀系统

这道题更像是在考系统设计思路。

事前:削峰和预热

这里我回答的是用 Spring 的 @Scheduled 注解做定时任务,在活动开始前定期把数据加载到缓存中。

  • 活动开始前把商品、库存、活动信息预热到 Redis。
  • 对接口做防刷设计,比如验证码、登录校验、限流、隐藏秒杀地址。
  • 静态资源走 CDN,减少应用服务器压力。

事中:限流和异步化

这里还是往并发上去说。

  • 网关层或接口层限流,超过系统承载能力的请求直接拒绝。
  • Redis 原子扣减库存,避免大量请求进入数据库。
  • 用消息队列异步下单,削平瞬时流量。
  • 对用户维度做幂等控制,防止重复下单。

事后:补偿和对账

这一步没什么思路,就说了说打日志和哨兵节点。复盘后发现,Redis 哨兵更偏向高可用保障,不是秒杀“事后补偿”的核心答案。这里更应该围绕补偿、对账和问题追踪来讲。

  • 消费消息失败时要有重试和死信队列。
  • 定时校验订单、库存、支付状态是否一致。
  • 对超时未支付订单进行关闭并回补库存。
  • 记录完整日志,方便排查问题。

数据库与事务

你认为什么是接口?

我当时第一反应是从前后端分离项目里的 API 接口去答:接口就是前端调用后端能力的入口,通过接口完成业务功能,比较常见的设计风格是 RESTful API。

复盘后发现,这道题最好先区分语境:

  1. Java 语法层面的接口

    • interface 是一种抽象规范,只定义能力,不关心具体实现。
    • 实现类通过 implements 实现接口。
    • 它常用于解耦、面向接口编程和多态。
  2. 系统设计层面的接口

    • 接口是系统对外暴露能力的契约。
    • 对前端来说,后端接口通常表现为 HTTP API。
    • 一个好的接口需要定义清楚请求路径、请求方法、参数、响应结构、错误码、鉴权方式和幂等规则。

如果面试官没有限定上下文,可以先说:“接口这个词有两层含义,一个是 Java 里的 interface,一个是系统对外暴露的 API,我分别说一下。”这样回答会更稳。

SQL 注入在事前、事中、事后如何防护

我当时回答了两部分:一是对前端的数据进行预处理,二是通过白名单防止 SSRF(服务端请求伪造)。这里其实答偏了,SSRF 和 SQL 注入不是同一类问题。

SQL 注入的本质是:用户输入被当成 SQL 语句的一部分执行了。比如把用户输入直接拼接进 SQL,就可能让攻击者改变原本的查询逻辑。

可以按事前、事中、事后三个阶段来回答:

事前:开发阶段避免注入点

  • 使用预编译语句和参数绑定,比如 PreparedStatement。
  • MyBatis 中优先使用 #{},避免把用户输入直接放进 ${}。
  • 不手写字符串拼接 SQL,尤其是登录、搜索、排序、筛选这类接口。
  • 对动态表名、排序字段这种无法参数化的位置做白名单校验。
  • 数据库账号最小权限,不给业务账号过高权限。

事中:运行阶段拦截异常请求

  • 对明显异常的参数做校验,比如超长输入、非法枚举值。
  • 对高风险接口做限流,避免被批量探测。
  • 可以接入 WAF 或网关规则,拦截典型注入 payload。
  • 记录关键 SQL 异常和异常请求来源,方便追踪。

事后:发现问题后的修复和复盘

  • 先下线或封禁异常入口,避免继续扩大影响。
  • 排查日志,确认被访问的数据范围。
  • 修复注入点,补充参数化查询和白名单校验。
  • 轮换可能泄露的账号密码或密钥。
  • 补充安全测试用例,避免同类问题再次出现。

这里还要注意一点:前端校验只能提升用户体验,不能作为安全边界。真正的防护必须放在后端和数据库访问层。

索引是什么?

这里回答上了,并往Explain性能分析上发散了一下,但把占用性能忘了,也是比较遗憾。

索引可以理解为数据库为了提高查询效率而维护的一种数据结构。没有索引时,数据库可能需要全表扫描;有索引后,可以通过索引快速定位到目标数据。

MySQL InnoDB 中常见的索引结构是 B+ 树。它的特点是:

  • 非叶子节点主要存索引值,用来导航。
  • 叶子节点存放完整数据或主键值。
  • 叶子节点之间有链表,适合范围查询。

索引不是越多越好。它会占用存储空间,并且在 INSERT、UPDATE、DELETE 时需要维护索引结构,所以会影响写入性能。

什么是事务?

这就是很简单的概念了,还可以往 Spring 的 AOP 特性上发散一下。

事务是一组数据库操作的逻辑单元,要么全部成功,要么全部失败。它的经典特性是 ACID:

  • A 原子性:事务中的操作要么全部成功,要么全部回滚。
  • C 一致性:事务执行前后,数据要满足业务约束。
  • I 隔离性:并发事务之间不能互相随意干扰。
  • D 持久性:事务提交后,数据修改要持久保存。

比如转账场景中,A 扣钱和 B 加钱必须放在一个事务里,否则就可能出现一边成功、一边失败的问题。

支付模块分为下订单、扣费、加积分,怎么确保一致性?

这一问我当时只想到了开事务,但没有继续往分布式场景展开。现在复盘来看,应该先判断这三个动作是不是在同一个服务、同一个数据库里。

如果这三个操作都在同一个服务、同一个数据库里,可以直接使用本地事务,把下订单、扣费、加积分放到同一个事务中。

但实际业务里,订单、支付、积分往往是不同服务,这时就变成了分布式事务问题。常见方案有:

  1. 本地事务 + 可靠消息

    • 订单和消息写入同一个本地事务。
    • 事务提交后,通过消息队列通知积分服务。
    • 积分服务消费消息时要保证幂等。
  2. TCC

    • Try 阶段预留资源。
    • Confirm 阶段确认提交。
    • Cancel 阶段释放资源。
    • 一致性更强,但业务改造成本更高。
  3. 最终一致性

    • 允许短时间不一致。
    • 通过消息重试、补偿任务、对账任务保证最终一致。

面试回答时可以先说明:强一致性成本高,实际业务里通常会结合可靠消息、幂等、重试和补偿来保证最终一致性。

下订单后保留 30 分钟,未支付恢复库存,怎么实现?各有什么优缺点?

这个问题本质是延迟任务。我现场只想到了 Redis 过期监听 和 轮询,还是缺乏开发经验。

方案 做法 优点 缺点
定时任务轮询 定时扫描超时未支付订单 实现简单,容易理解 不够实时,扫描压力大
Redis 过期监听 给订单 key 设置 30 分钟过期,监听过期事件 实现不复杂,实时性较好 Redis 过期事件不保证绝对可靠
延迟队列 下单后发送 30 分钟后投递的延迟消息 可靠性较好,适合生产 依赖 MQ,系统复杂度更高
时间轮 用时间轮管理大量延迟任务 性能好,适合大规模定时任务 实现和维护成本更高

生产上更推荐 延迟队列 + 幂等关闭订单:

  1. 创建订单时锁定库存,并发送一条 30 分钟后触发的延迟消息。
  2. 消息到期后检查订单状态。
  3. 如果仍未支付,则关闭订单并恢复库存。
  4. 如果已经支付,则不做处理。

这里必须注意幂等。因为消息可能重复投递,关闭订单和恢复库存都不能重复执行。

生产故障排查

如果一台服务器的内存意外跑到了 100%,你会怎么排查?

这一问我在掘金上看到有人发过帖,可惜只是走马观花看了一下,没能回答上,比较遗憾。

可以按照“先止血、再定位、最后复盘”的思路回答。

第一步:确认现象

  • 用 top 或 htop 看整体内存、CPU 情况。
  • 用 free -h 看内存和 swap 使用情况。
  • 用 ps aux --sort=-%mem | head 找出最占内存的进程。

第二步:定位进程

如果是 Java 进程,可以继续看:

  • jps -l 找 Java 进程。
  • jstat -gcutil <pid> 1000 观察 GC 情况。
  • jmap -histo:live <pid> 看对象数量和大小。
  • 必要时用 jmap -dump 导出堆快照,再用 MAT、VisualVM 等工具分析。

第三步:结合日志和业务判断

  • 最近是否上线了新版本。
  • 是否有大流量请求或异常接口。
  • 是否有大对象缓存、集合无限增长、线程池堆积。
  • 是否存在文件读取、批量查询一次性加载过多数据的问题。

第四步:临时止血

  • 如果服务已不可用,可以先扩容、限流或重启异常实例。
  • 如果是某个接口导致的,可以临时下线入口或降级。
  • 止血后再保留现场信息,避免重启后证据丢失。

Java 基础

OOP 特点

OOP 主要有四个特点:

  • 封装:把属性和行为封装到对象内部,对外暴露必要接口。
  • 继承:子类复用父类的属性和方法。
  • 多态:同一个接口或父类引用,在运行时可以表现出不同实现。
  • 抽象:提取共性,隐藏不必要的细节。

面试里可以重点讲封装、多态和抽象。继承虽然常见,但实际开发中过度继承也容易导致类层级复杂。也可以刚好引出 Java 为什么没有多继承:避免菱形继承问题。

类和对象的区别

类是模板,对象是类的实例。

比如 User 是一个类,它定义了用户应该有哪些属性和行为;而 new User() 创建出来的某一个具体用户,就是对象。

换句话说,类描述“是什么”,对象表示“具体是哪一个”。

构造函数有哪几种?

在 Java 里常见的说法有:

  • 无参构造函数:没有参数,用于创建默认对象。
  • 有参构造函数:通过参数初始化对象属性。
  • 默认构造函数:如果类里没有显式定义任何构造函数,编译器会自动生成一个无参构造函数。

需要注意的是:如果已经手写了有参构造函数,Java 就不会再自动生成无参构造函数。这时如果框架或代码需要无参构造,就要自己补上。

这一问我当时答得比较窄,只答了 Java 里最常见的构造函数。复盘后可以再补一层:构造对象不一定只靠构造函数,很多框架和设计模式会把对象创建过程封装起来。

从 Java 基础角度看,构造函数主要看是否有参数、是否由编译器默认生成;从工程实践角度看,对象还可能通过工厂方法、Builder、反射、反序列化、Spring 容器等方式创建。面试时如果能区分“构造函数”和“对象创建方式”,回答会更完整。

你怎么看待 new 一个对象?

我理解的 new 不只是“创建一个对象”这么简单,它背后至少包含几个步骤:

  1. 在堆内存中为对象分配空间。
  2. 对对象字段进行零值初始化。
  3. 执行构造方法中的初始化逻辑。
  4. 返回对象引用,让栈上的变量可以指向这个对象。

从 JVM 层面看,对象创建还可能涉及类加载检查、内存分配方式、对象头、引用指向等内容。面试时如果能从“语法层面、内存层面、JVM 层面”逐层回答,会比只说 new 是创建对象更完整。

反问环节

我的问题是:我这次面试还有什么能改进的地方?

对方回答(大致)是:“作为一个大二学生,能回答上大部分问题已经很好了,但底层方面还是比较匮乏。如果想要做一个好的后端工程师,还是应该向 JVM 内存、Spring 原理、汇编等方面加深学习。”

感悟

整体上大概回答了 2/3,剩下的能编就编,要么就往自己的项目或熟悉的领域去扯,实在不了解的部分就直接 gg 投降。

平时刷博客还是有用的。服务器跑满内存的示例我刚好在掘金看到有人发过,虽然具体记不太清了,但还是勉强扯了一下。

说实话没想到对方会问到这些,因为大家都是大二的,虽然对方也表示了没期望有人能全部回答上。我原本以为大致 10 分钟就能结束战斗,结果硬生生聊了三十几分钟。

这次面试给我的最大提醒是:项目经历只能证明“做过”,但面试会继续追问“为什么这么做、底层怎么实现、出问题怎么排查”。后面还是要把 JVM、Spring、Redis、MySQL、Linux 排查这些内容系统补一遍,不能只停留在会用 API 的层面。

总体而言,第一次面试还是受益匪浅,面试官也很友善,在知道我没有学习计网后就直接换了题型。三位面试官也都在我思考问题时耐心等待,也没有压力面,可以说体验很好。

出于隐私原因,这里就不放公司名称了。

0%