《深入理解 AI Agent》笔记 - 2 上下文工程
前言
从这一章开始,就和使用 Agent 关联比较大了。
我认为需要关注的几个点: token注意力机制、上下文的构成、上下文的运行机制
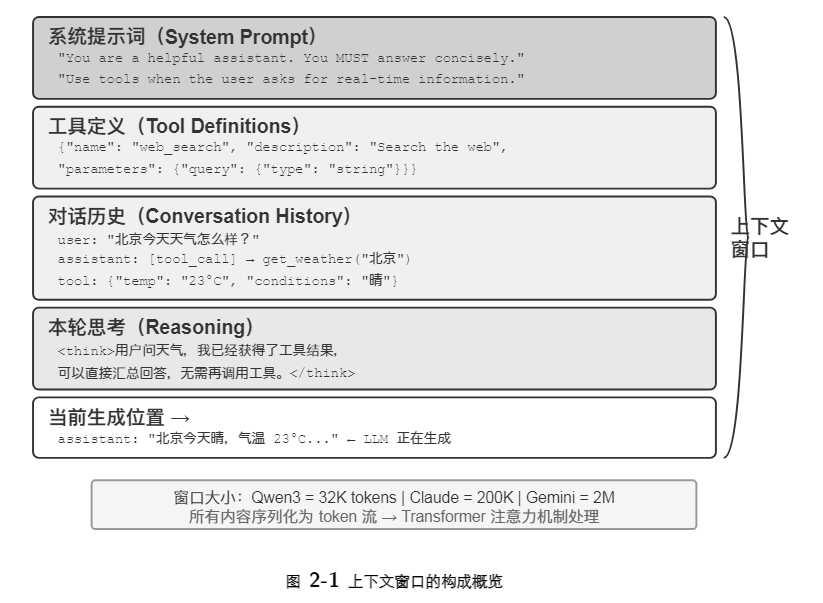
上下文:决定 Agent 能力上限的关键
通用模型并不知道具体项目的架构、业务规则和团队约定。以 Coding Agent 为例,代码库结构与规范、Git 和审查流程、运行环境信息,都是完成“修复这个 bug”所需的最低背景;缺少这些信息,模型可能写出语法正确却无法融入项目的代码。因此,上下文工程不是简单地往 Prompt 里塞更多文字,而是系统性地组织 Agent 在每个决策点真正需要的观察、历史和约束。上下文质量足够高时,中等模型也可能胜过信息匮乏下的顶级模型。
消息的角色
- system:系统提示词。由开发者编写,定义 Agent 的身份、行为规则、约束条件。模型将其视为最高优先级的指令。整个对话过程中通常只有一条,放在消息列表的最前面。
- user:用户消息。来自终端用户的输入,是 Agent 需要响应的请求。
- assistant:助手消息。模型之前的回复,包括文本回复和工具调用请求。在多轮对话中,之前的 assistant 消息会被放回消息列表,让模型“记住”自己说过什么。
- tool:工具结果。Agent 框架执行工具后,将结果以 tool 角色的消息送回给模型。每条 tool 消息通过 tool_call_id 与对应的工具调用请求关联。
上下文的调用
依旧查询天气
第一次
1 | // ═══ Request constructed by the Agent framework (1st call) ═══ |
第二次
1 | // == Request constructed by the Agent framework (2nd call) == |
- 第二次请求包含了第一次的全部对话历史——system 消息、user 消息、第一次的 assistant 回复(包含工具调用),以及新增的 tool 结果。这就是前面所说的“每次调用都是无状态的”:模型不会“记住”上一次的对话,Agent 框架必须每次都把完整历史送回去。
- 第一次的 assistant 消息被原样放回消息列表——这让模型能“看到”自己之前做了什么决策。
- tool 消息通过 tool_call_id 与对应的工具调用关联——模型据此知道哪个结果对应哪个调用。
这里我重点关注的是:下一次请求会包含上一次的对话历史。这意味着:随着对话次数增多,可能你只是问一个小问题,但也会带上之前所有的对话历史,这也是上下文窗口不足的主要原因。对codex来说,过长的上下文会触发上下文压缩机制,但这也会导致 codex 失去对历史信息的精度。所以,要妥善处理上下文的长度,及时开启新的对话。
我一般会在上下文达到 70% 以上时告诉codex:由于上下文长度原因,我需要重新开启一个对话窗口,总结本次任务的进度并生成可直接交付给下个窗口的命令。
我学到了一种新的更好用的方式,更新一下:
在系统提示从中让 agent 维护一份 progress.md ,里面记录 agent进行的所有操作,并在根目录中维护一份 AGENT.md ,存在核心规则和重要记忆。
KV Cache
解释:
算是一种缓存机制:把前文的中间计 算结果缓存下来,下一轮只需要计算新增 token 的部分。前提是要复用的上下文 token 前缀保持不变——若 token 序列从某个位置开始不同,首个不同 token 及其后的 KV 状态需要重新计算;此前位置的 KV 状态不受这次改动 影响。
假设上下文有 4 个 token [A, B, C, D],模型正要生成第 5 个 token E。注 意力的核心操作是:E 的查询向量(Query)与所有已有 token 的键向量(Key)做点积来计算匹配度(点积的直 观含义见实验 2-2),再根据匹配度对所有 token 的值向量(Value)加权求和,得到 E 的输出表示。 不使用 KV Cache 时,每生成一个新 token 都要从头计算前面所有 token 的 K、V 向量:生成 E 时要计算 5 组 K、V,生成第 6 个 token 时要计算 6 组⋯⋯到第 N 个 token 时要计算 N 组,总计算量与 N² 成正比。 使用 KV Cache 时,A、B、C、D 的 K、V 向量算过一次后就缓存起来。生成 E 时,只需要计算 E 自身的 K、V,然后与缓存中的 4 组一起完成注意力计算。需要注意的是,KV Cache 省去的是历史 token 的 K、V 投影 重算,使每步解码不必重算整个前缀;但每个新 token 的注意力计算仍要遍历全部缓存的 K、V,计算量随上下文 长度线性增长——这正是长上下文解码越来越慢、KV Cache 的显存与带宽成为推理瓶颈的原因。
Chat Template
token 序列(如 <|im_start|>、 <|im_end|> 等特殊标记)看起来与前面 API 的 JSON 格式很不一样。这是因为 API 层面的结构化消息需要被转 换为模型能理解的线性 token 流——负责这个转换的就是 Chat Template(聊天模板)。
对于 Agent 开发者来说,你不需要手动编写或修改 Chat Template——API 服务端会自动处理。但理解它的
存在对 Agent 开发有两个实用价值:
第一,解释了为什么必须使用标准 API 格式。如果开发者绕过 API、自行拼接消息(比如把工具结果作为普
通 user 消息而非 tool 类型传递),Chat Template 会误将工具响应识别为新的用户查询,导致模型的思维链保留
机制被破坏。
以 Qwen3 的 Chat Template 为例:模型在多轮工具调用中,会把之前的内部思考过程(
第二,解释了 KV Cache 为什么对前缀如此敏感。Chat Template 将 system 消息和工具定义转换为固定的 token 序列放在最前面。这些 token 的键值对(Key-Value pairs)被缓存后可以跨请求复用。但如果前缀中某个 token 发生变化——哪怕只是系统提示词里多了一个空格——首个不同 token 及其后的缓存就无法复用。
提示词工程
核心对象是系统提示词(System Prompt)——API 消息列表中 role: “system” 的消息。
语气与风格:系统提示词的“人格”
语气和风格的设计是提示工程中最容易被忽视,却又深刻影响用户体验的部分。例如,可以要求“You MUST answer concisely with fewer than 4 lines”(你必须简洁地回答,不超过 4 行);在无法完成任务时,则要求“keep your response to 1-2 sentences”(把回复控制在 1-2 句话),并且“不要解释为什么不能做某事”。这种设计避免了 Agent 陷入冗长的自我辩护。大写字母(如“NEVER do X”)比“Please avoid doing X”更能引起模型的“注意”,但 过度使用会导致效果被稀释,应保留给真正关键的约束。
结构化提示:系统提示词的“格式”
现代大语言模型对结构化输入展现出显著的敏感性,这源于训练数据中包含大量的结构化内容。XML 标签的
使用遵循层次化原则,其标签名称本身就携带语义信息——
流程驱动 vs 规则堆砌:系统提示词的“组织方式”
流程设计让模型在任何时刻都能清楚地知道自己处于哪个阶段、当前步骤的目标是什么、完成后该进入哪 个步骤。当遇到异常时,模型可以根据当前所处的阶段确定处理方式,而不是遍历所有规则去寻找匹配项。
Few-shot
示例(few-shot examples)是系统提示词中另一类重要内容。当期望的输出难以用规则精确 描述时——比如特定风格的文案、结构化报告的格式、客服回复的语气分寸——与其堆砌冗长的文字定义,不如直 接给出两三个高质量的输入-输出示例。模型会凭借上下文学习能力从示例中“临时学会”这些模式,其效果往往胜过 等量篇幅的抽象规则。反过来,对于模型本来就擅长、规则又容易说 清的任务,示例只是浪费 token。 工程上有两个决策点。第一,示例放在哪里:放在系统提示词中,示例成为静态前缀的一部分,对所有请求生 效;也可以伪造一组 user/assistant 消息放在首轮对话中,适合按会话类型选用不同示例集的场景。第二,示例对 KV Cache 前缀稳定性的影响:无论放在哪个位置,示例都处于上下文靠前的区域,一旦确定就应当保持字节级稳 定——如果按请求动态检索“最相关”的示例,等于每次都改写前缀,缓存会持续失效。因此生产系统通常为每类任 务准备固定的示例集,而不是逐请求挑选。
提示注入:上下文安全的核心威胁
Agent 会处理网页、邮件和文档等外部内容,这些内容可能夹带伪装成指令的恶意文本,例如要求 Agent 忽略既有规则、泄露对话历史或执行文件写入。提示注入比普通聊天中的越狱更危险,因为 Agent 具备真实的工具调用能力;每一个读取外部内容的工具都可能成为注入入口。
上下文层的防御重点是区分“指令”和“数据”:对外部内容使用明确的来源标记(如 <external_content source="webpage">),严格使用 system/user/assistant/tool 角色传递消息,并把输入清洗作为辅助措施。第三方 Skill 和状态栏同样可能成为新的注入面,所以只能把这些措施视为第一道防线,高风险操作仍需权限控制、沙盒隔离和独立确认。
Skills
出现原因
随着 Agent 覆盖的业务场景越来越多,系统提示词会不断膨胀——客服场景的退款规则、编程场景的代码规 范、文档场景的格式要求⋯⋯全部塞进一个提示词,会带来两个问题:
- 浪费 token:大部分内容与当前任务无关
- 注意力被稀释:上下文中无关信息过多会稀释模型对关键内容的注意力
渐进式披露机制
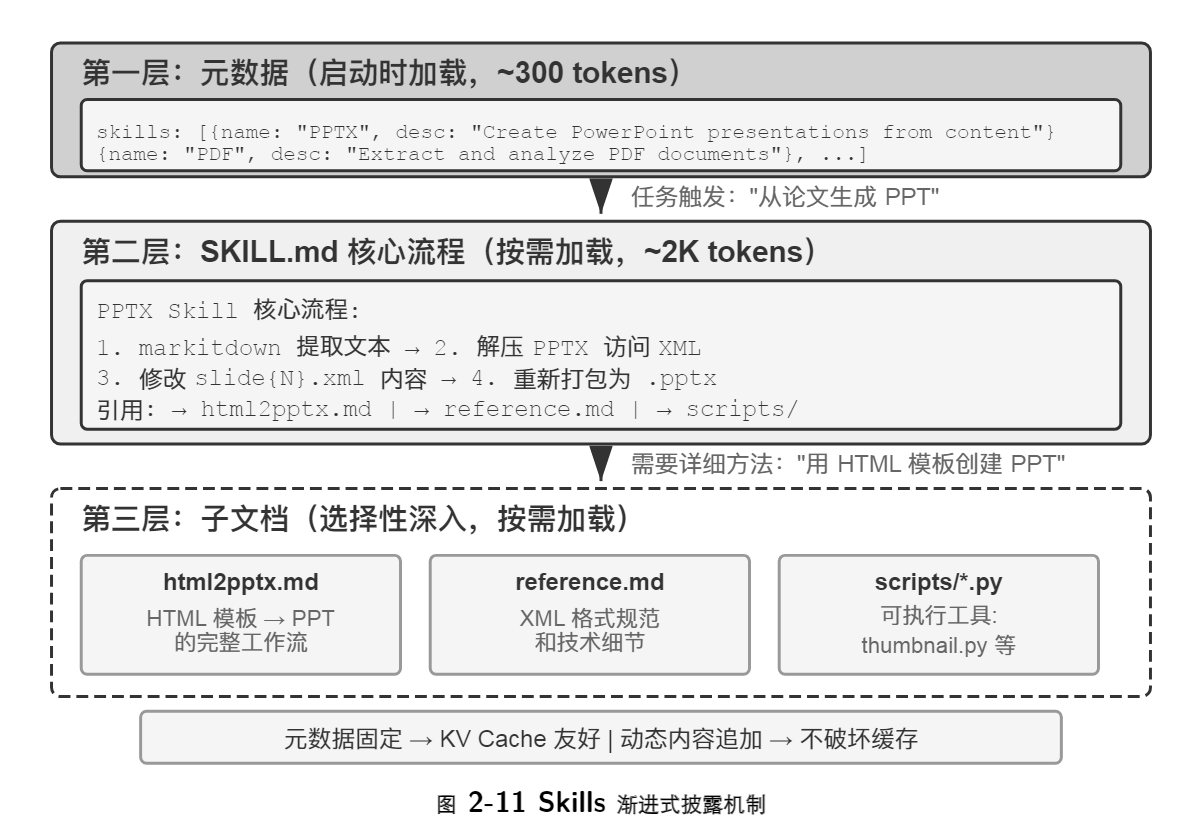
构成
元数据
每个 Skill 必须包含一个 SKILL.md 文件,开头是 YAML frontmatter(即文件顶部用 — 分隔的元数据块,类似书籍的版权页),包含 name 和 description 两个字段。目录应在主体正文加载前对 Agent 可见,使它能够先判断当前任务是否需要某项能力,而不必为所有能力支付完整的上下文成本。不同运行时可以把 目录放在不同的上下文层,目录的共同作用是提供可发现性,而不是承载完整的领域流程。
核心流程
当 Agent 判断某个任务需要特定的 Skill 时,运行时才加载完整的 SKILL.md。Claude Code 会在调用位置把 Skill 指令作为 user message 加入会话;采用文件读取或专用激活工具的其他运行时,也 可以把内容作为 tool result 返回。以 PPTX Skill7 为例,其中包含处理 PowerPoint 文件的核心流程:如何通过 markitdown(Microsoft 开源的文档转 Markdown 工具)提取文本,如何解压 PPTX 文件访问原始的 XML 结构, 以及关键文件的路径约定。
细则
通过文件引用深入到更详细的子文档。主文件引用了 html2pptx.md(通过 HTML 模板创建 PowerPoint 的详细工作流)、reference.md(格式技术细节)等。Agent 会根据具体的需求选择性地深入阅读相关 的子文档。
Agent 状态栏
当对话变长时,模型需要反复从原始轨迹中统计“当前做到哪一步、某个工具调用了几次、还剩哪些约束”。可以在轨迹末尾追加一段由代码维护的状态栏,集中记录当前阶段、任务进度、工具计数、失败原因和环境信息,让模型直接检索这些元信息,而不必每次遍历全部历史。状态栏应放在动态消息区域,不要写入系统提示词,否则会破坏稳定前缀和 KV Cache。
状态栏是对原始历史的有损摘要,模型通常会直接相信其中的数字,因此应优先由程序确定性维护,必要时再逐项抽取后汇总。它能节省上下文并减少重复推理,但不能替代所有原始记录;涉及状态栏未记录的维度时,仍需保留或回溯原始证据。
上下文压缩策略
上下文压缩不只是为了避免窗口溢出,也能减少成本和延迟、降低无关信息造成的“上下文腐化”,并把模型需要反复归纳的结论提前整理成可直接检索的知识。生产系统通常在接近预算阈值时批量压缩旧的工具结果,保留决策、约束、失败原因和引用;系统提示词与核心工具定义尽量保持不变,以保住 KV Cache 的静态前缀。
压缩策略应遵循三点:信息价值并不均匀,关键事实和决策优先保留;摘要不能丢失时间、主体和因果等语义完整性;压缩内容要与当前任务相关,检索、分析和创作任务的保留重点并不相同。噪声可以直接删除,重要轨迹则可分层摘要并保留来源。
另一个常被忽视的办法是“隔离优于压缩”:让子 Agent 在独立上下文中完成大范围搜索,只把结论性摘要回传主 Agent。这样中间过程不会污染主上下文,也不会破坏主 Agent 的缓存,但子任务描述必须足够明确,且返回结果要保留可核查的依据。